DeepSeek V4.1 Flash:架构学习笔记
By AI Dance (@AI_Whisper_X)
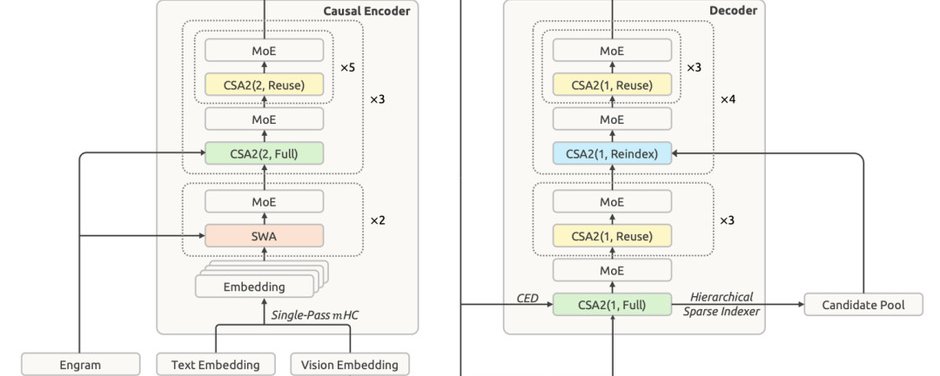
DS 的架构创新还是太屌了。
放出来的已经是这个样子,很难想象他们背后做了多少探索。
DeepSeek 发布了 V4.1 Flash,采用 Causal Encoder-Decoder(CED)结构,输入和输出的计算不对称:处理输入时,每个 token 激活约 8B 参数;生成时约 16B。
先聊架构方面的创新。
这套设计受到 YoCo 启发。相关前作是 2024 年的《You Only Cache Once: Decoder-Decoder Architectures for Language Models》。它们都在探索:让前半段提供记忆,后半段复用,从而减少重复计算与缓存。
前作论文:You Only Cache Once(YoCo,2024)
Causal-Encoder-Decoder 到底做了什么?
先分清模型使用时的两个阶段:
- Prefill:处理已经拿到的输入,建立缓存。
- Decode:利用已有上下文,逐步生成输出。
KV 缓存可以粗略理解为模型保存的“上下文笔记”。生成下一个 token 时,模型直接读取已有历史的状态,不用把全部历史重新计算一遍。这里的“笔记”是数字表示,不是文字摘要。
普通 Decoder-only Transformer 中,各层通常依据自己的中间状态建立 KV 缓存。因此,在处理尚未缓存的长输入时,输入 token 通常要经过整个网络。
DeepSeek 改变了后半段网络的全局 KV 来源:这些 KV 从前半段的最终输出构造,不必为了建立后半段的全局记忆,让全部输入再跑完后半段。
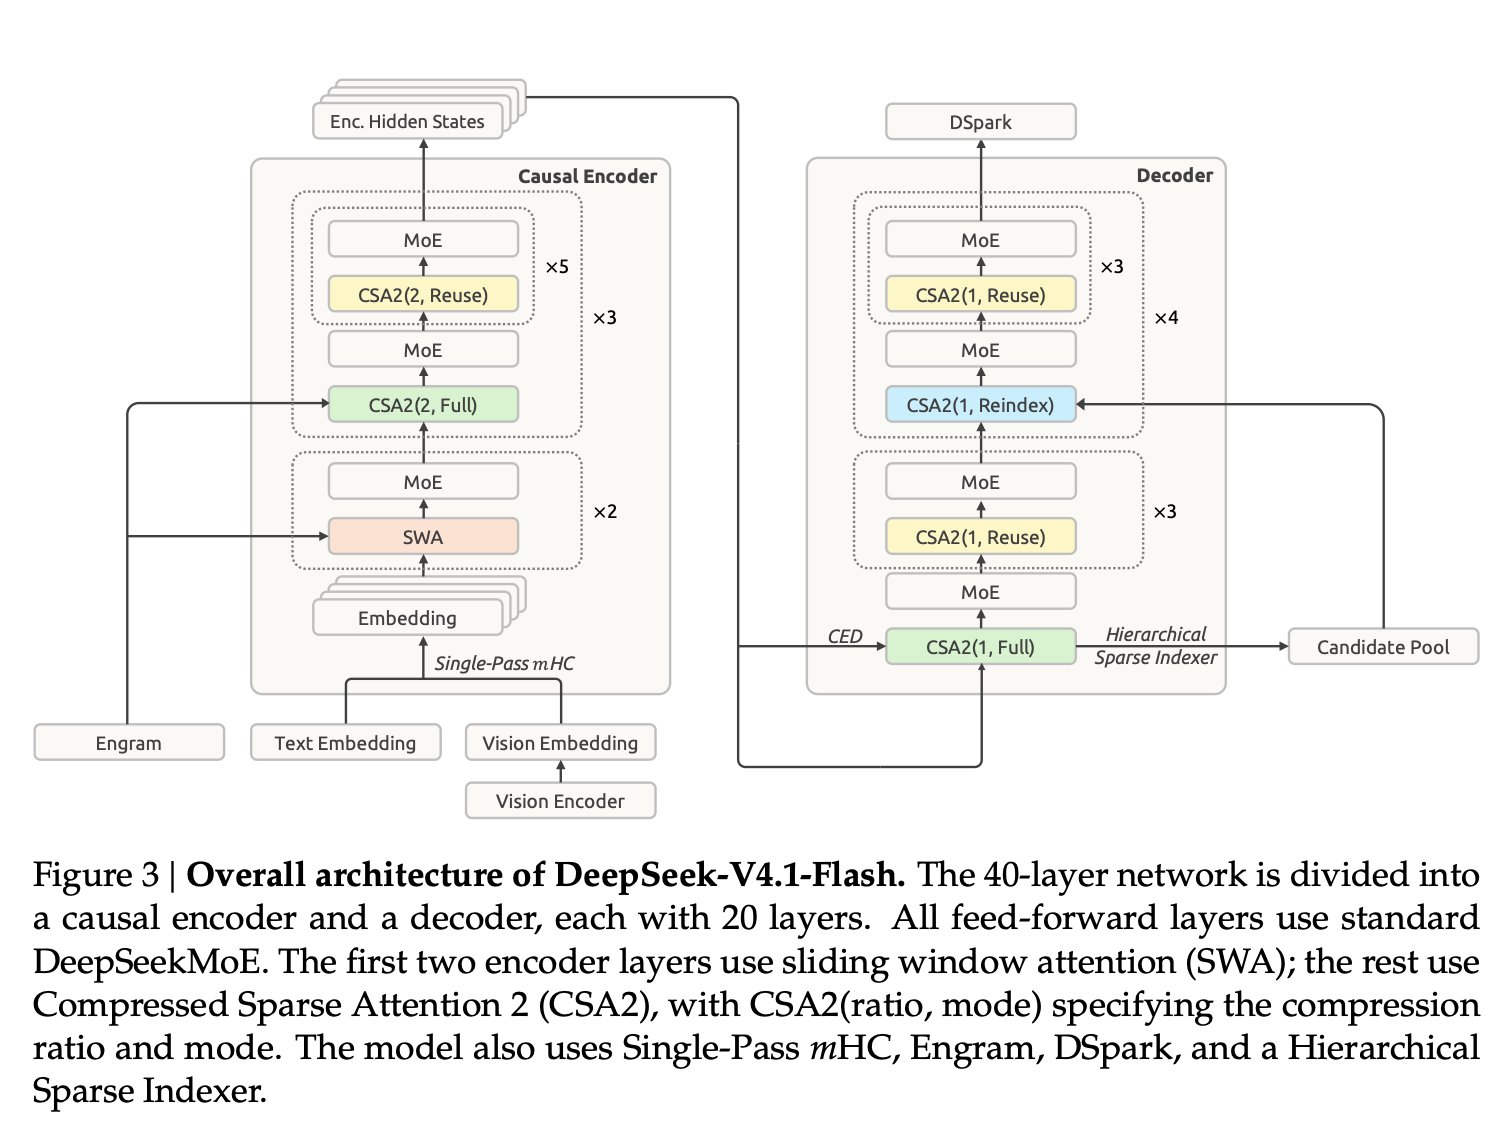
图 1|先看前后两个大框:语言主干各 20 层;Encoder 输出用于构造 Decoder 的全局 KV。图源:DeepSeek-V4.1-Flash 技术报告 Figure 3,第 7 页。
具体来说,V4.1 Flash 的主干共有 40 层:
- 前 20 层叫 Causal Encoder。
- 后 20 层叫 Decoder。
- 后半段的全局 KV由前半段最终输出经过投影生成,不必为了建立这些 KV,把全部输入再跑完后 20 层。
于是计算路径大致变成:
处理长输入 / Prefill
输入 → 前 20 层 → 构造后半段全局 KV
末尾 128 token 还需经过 Decoder,补齐局部窗口状态。
生成下一步 / Decode
当前 token → 前 20 层 → 后 20 层 → 预测下一个 token
前后两部分都读取相应缓存,并为新增位置建立状态。
这里有两个容易误读的地方。第一,生成时前后 40 层仍然全部运行,16B 是整条生成路径的激活参数口径,不是 Decoder 单独的大小。第二,后半段仍保留逐层的滑动窗口注意力,因此输入阶段也需要对末尾一小段做补算。对足够长的输入,prefill 计算量接近减半,但不能直接推导成所有请求耗时减半。
但此 Encoder 非彼 Encoder
Encoder 是“编码器”:把输入转成后续网络可用的表示。这里前 20 层承担为后半段构造全局记忆的职责,所以叫 Encoder;20+20 只是这款模型的配置。Causal 则规定了信息的方向:每个位置只能利用当前位置和此前的信息,不能提前看后文。
比如一句话:
小明把苹果吃了。
传统双向 Encoder 在处理“小明”这个位置时,可以利用后面的“苹果”“吃了”。
Causal Encoder 在“小明”这个位置不能提前利用后文;处理到“吃了”时,才可以利用此前的信息。Causal 指的是“不能看未来”的依赖限制,不代表模型因此具备因果推断能力。单向依赖也不等于 prefill 必须逐字串行:已知输入仍可通过掩码并行计算。
真正贯穿论文的主题,是 KV 缓存压缩
这篇报告的主线是:长上下文不只是“算得贵”,还“存得贵、搬得慢”。Agent 反复读取网页、代码和工具结果,历史越来越长,缓存的存储与搬运也会成为瓶颈。DeepSeek 因而同时减少重复存储、降低缓存精度,并重新决定哪些状态值得长期保留。
最关键的结果是:全局 KV 降至约 890 字节/token,在相同上下文长度下,约为 V4 Flash 的 1/4;在报告所述的相同工作负载下,持久化 KV 缓存约为上一代的 1/8。这两个比例针对缓存,不代表整个模型的显存或硬盘需求同比下降。
1、先分清:DeepSeek 把上下文记忆分成两类
- 全局 KV:从很久以前的上下文中找信息,随上下文长度增长。
- 局部 SWA KV:精细处理最近一小段内容。窗口固定,因此单份局部缓存的大小有上限。
V4.1 Flash 的局部窗口是 128 token,各层保留自己的局部状态。
可以把它理解为:近处保留细致、逐层加工的工作记忆,远处使用可以共享、压缩和检索的全局笔记。全局缓存包括真正供注意力读取的 main KV,以及帮助检索的 indexer K。
2、最大的结构变化:很多层共用一份全局 KV
普通架构里,各层通常保存各自的 KV。即便里面存在重复信息,也要分别占空间。
V4.1 的 CSA2,也就是 Compressed Sparse Attention 2,设置了三种层模式:
- Full:建立新的全局 KV,并挑选本次需要读取的位置。
- Reindex:复用前面的全局 KV 和 indexer K,用自己的索引查询重新挑选位置。
- Reuse:复用前面的全局 KV,也沿用最近一次对应的 Top-K 位置,不再重复检索。
这里共享的是全局 KV 和选中的位置;每层仍保留自己的注意力查询 Q 与局部 SWA KV,不能理解为跳过整层计算。
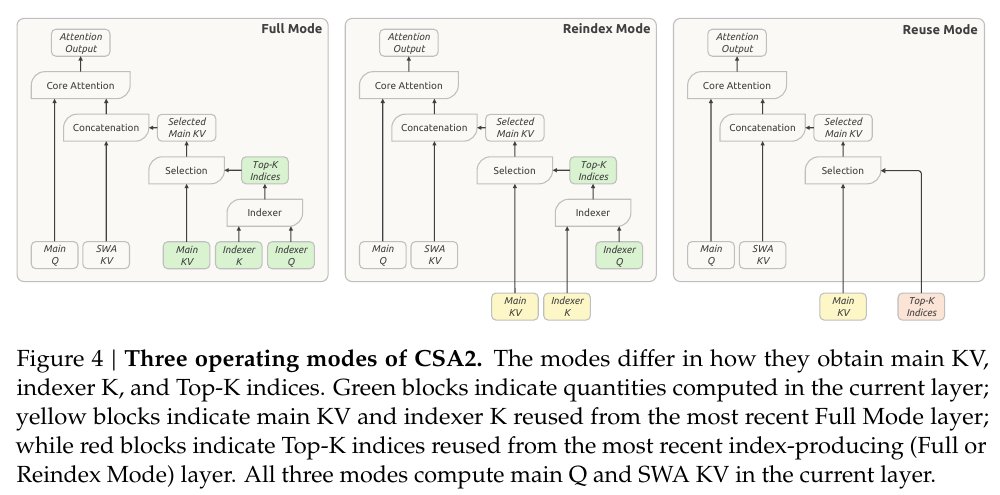
图 2|CSA2 三种模式:绿色为本层新算,黄色为复用 KV,红色为复用选中位置。三种模式都保留自己的查询与局部 KV。图源:官方报告 Figure 4,第 10 页。
这解决了两种不同的浪费:
- 共用 KV,减少重复存储。
- 共用检索结果,减少重复查找。
实际配置非常激进:
- Encoder 第 1–2 层:计算与共享方式:仅局部 SWA;全局 KV:无
- Encoder 第 3–20 层:计算与共享方式:3 组×6 层;每组 1 层 Full+5 层 Reuse;全局 KV:3 组
- Decoder 共 20 层:计算与共享方式:1 层 Full、4 层 Reindex、15 层 Reuse;全局 KV:共用 1 组
也就是说,38 个有全局注意力的层,只对应四组全局 KV。四组指的是四套随上下文增长的记录,不是四个向量。也不能据此说比 V4 节省 38/4 倍:上一代本身已有压缩,各组的序列压缩率也不同。
少存之外,还要少查。CSA2 每次为当前查询选最多 512 条全局记录做注意力,同时结合局部窗口。没有选中的记录仍然保留,因为下一个查询可能用到它们。只读 512 条,不等于只存 512 条。
分层检索进一步减少重复查找:Decoder 的第一个 Full 层扫描全部因果可见位置,按块建立共享候选池,最多 2048 块×8 个位置=16384 个位置。后续 Reindex 层只在池内挑自己的 Top-512,Reuse 层直接沿用结果。
固定候选池大小后,后续检索器每个查询的打分量不再随上下文长度增长。但第一遍全局扫描仍然存在,整体缓存也仍随上下文增长。这项分层索引只用于 Decoder,并在后训练中适应同样的候选限制。
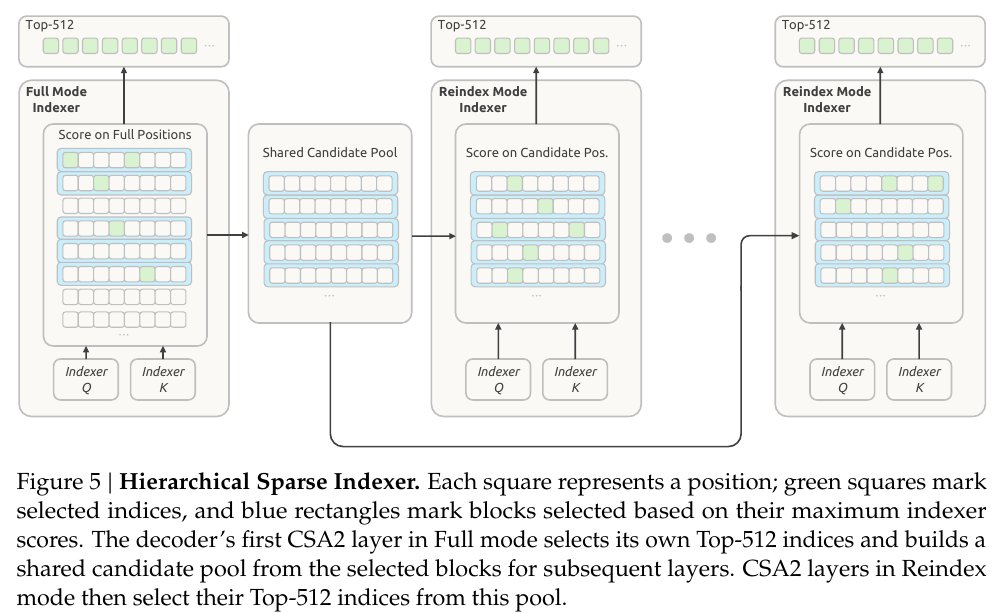
图 3|第一次扫描全局并圈定候选池,后续检索器只在池内选位置。候选池最多 16384 个位置,最终每次选最多 512 条。图源:官方报告 Figure 5,第 11 页。
3、序列维度也压缩,但并非处处猛烈压缩
前面 3 组 Encoder 的全局 KV,采用 2 个 token 压成 1 条记录;Decoder 的全局 KV 压缩率是 1,即不合并 token 位置。
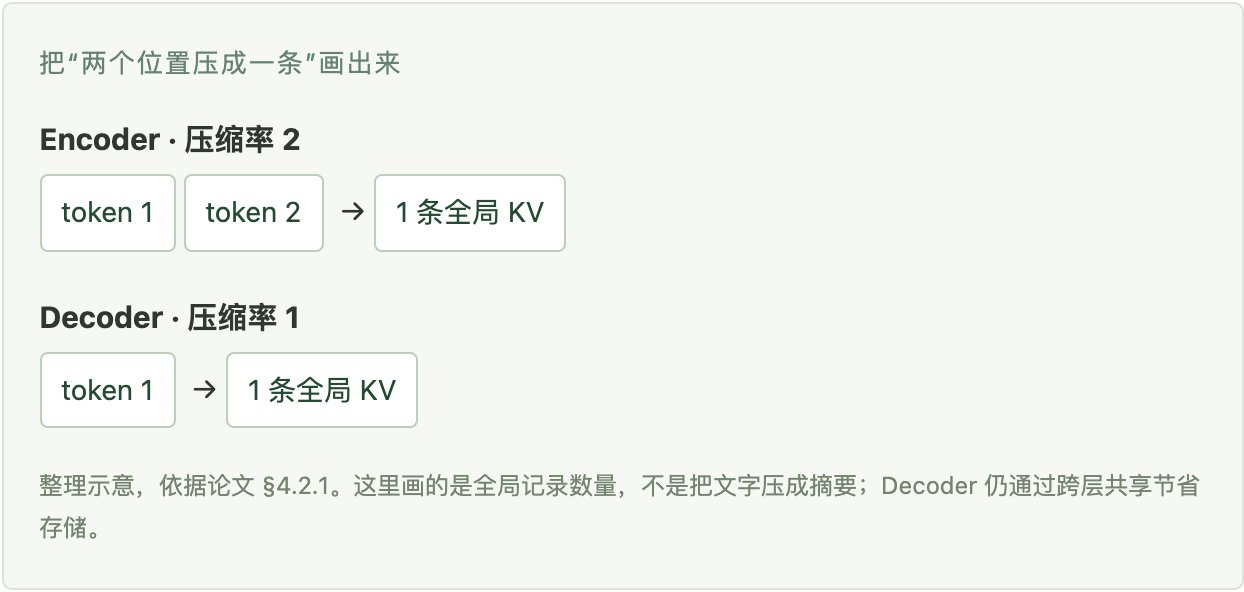
这个取舍很有意思:Decoder 保留逐位置的全局记录,主要通过跨层共享来节省空间,并没有把所有信息都压成粗略摘要。V4 的全局分支采用 CSA+HCA 混合结构,V4.1 则改为纯 CSA2。
4、每条记录再变小:主 KV 从 FP8 降到 FP4
原本每个数大约用 8 bit,现在主体用 4 bit。
不过实际不是恰好减半,因为还要存缩放系数。报告采用:
- 每个数使用 E2M1 的 4 bit 格式;
- 每 16 个通道共用一个 8 bit 缩放系数。
仅按数值和缩放系数这两项算,平均每个数是:4+8/16=4.5 bit。
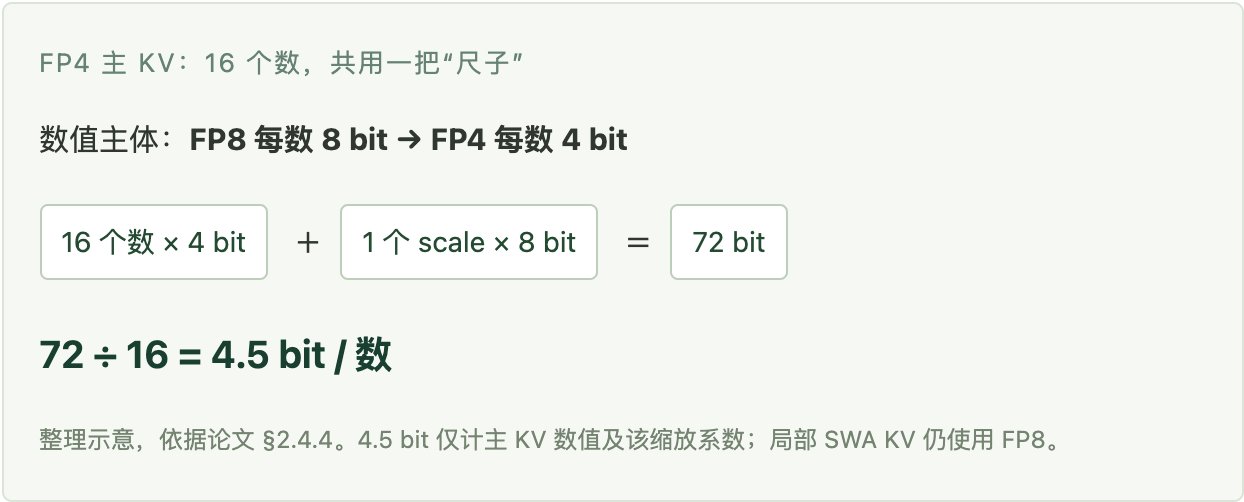
这不是训练完后随手砍掉一半精度。模型在后训练中加入量化感知训练(QAT),适应低精度缓存;读取时再反量化,交给注意力计算。更敏感的局部 SWA KV 继续保留 FP8。这里主要省的是存储,不等于注意力矩阵乘法直接用 FP4 加速。
5、持久化 KV 缓存为什么能降到上一代的 1/8?
因为他们发现:长期保存局部 SWA 状态不划算。
上一代的持久化缓存里,SWA KV 占了接近一半空间。虽然单份只是一个窗口,但多轮对话会留下很多用于续接、重新生成的缓存点。
两类数据的生命周期也不同:
- 全局 KV 可能隔很久还被命中,值得长期保留。
- 局部 SWA 状态主要在活跃会话的几分钟内有用。
于是 V4.1:
- 全局 KV 继续长期保存。
- Encoder 的 SWA 状态放进短期内存池,按分钟过期。
- 不再将 SWA KV 放入长期持久化缓存。
- 全局 KV 命中但 Encoder 的 SWA 状态缺失时,回放已缓存前缀末尾的 128 token,近似恢复局部状态,同时处理新增输入。
按报告描述的旧缓存组成,可以粗略理解为:不再长期保存原先占近一半的 SWA KV,再把留下的全局 KV 压到 1/4,约为 1/2×1/4=1/8。这是存储策略与架构、精度优化共同产生的结果,不是 FP4 单独带来的。
这里还有一个很重要的技术取舍:重算得到的是近似状态。
Decoder 则在每次 prefill 时,对整个 prompt 末尾的 128 token 做有限回放,建立生成阶段所需的 SWA KV。这些局部状态用于随后生成,不进入前缀持久化缓存。
多层局部注意力的依赖范围会累积,精确恢复所需的回放长度会随层数增长。例如,论文给出的 20 层 Decoder 理论回放长度为 20×128=2560 token;有限回放只处理最后 128 个,并截断更早的局部依赖。报告称质量影响很小,但明确承认这与完整计算不数学等价;Decoder 侧还在后训练中模拟这种回放,让模型适应。
6、CED 在这套设计里扮演什么角色?
- CED:从 Encoder 输出构造 Decoder 全局 KV,减少长输入计算。
- CSA2 跨层共享:减少全局 KV 的重复存储,并复用部分检索结果。
- FP4 缓存:降低每条主 KV 记录的存储体积。
- 稀疏选择与分层检索:限制本次读取条数,减少后续检索器的搜索范围。
- SWA Bounded Replay:用少量近似回放恢复局部状态,减少长期保存,并限制 Decoder 补算。
按 890 字节/token 计算,100 万 token 的全局 KV 约为 0.89 GB(十进制 GB)。这是很显著的压缩,但还不包含模型权重、局部缓存、工作区和其他运行开销。
再看论文里的计算量曲线:上下文从 4K 拉到 1M(256 倍),单 token decode FLOPs 只增加约 25%。这个数字采用精度加权口径:BF16、FP8、FP4 分别按 1、0.5、0.25 计入。它不是实际延迟或吞吐测试,也不能单独归功于 CED,而是整套设计共同作用的结果。
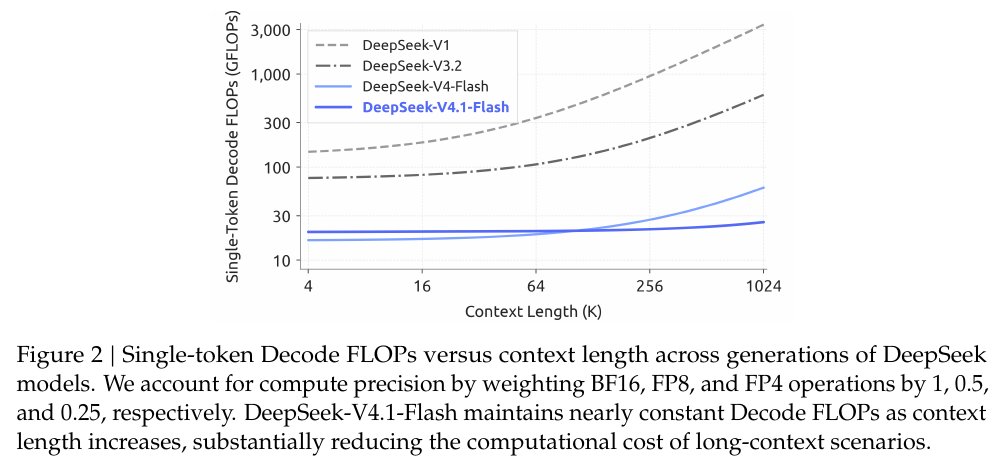
图 4|上下文长度与单 token decode 的精度加权计算量,两轴均为对数尺度。该图不是实际延迟测试。图源:官方报告 Figure 2,第 5 页。
越读越觉得,厉害的不只是某一个点子,而是这些设计怎么配合起来:哪些记忆共享、哪些降低精度、哪些不值得长期存、哪些需要时再补算。对不断积累历史的 Agent 来说,长上下文“装得下”之后,还得“反复用得起”。
来源:DeepSeek-V4.1-Flash 技术报告,重点参考 §2.2、§2.3、§2.4.4、§3.2、§4.2.1。