Inside vLLM:高吞吐 LLM 推理系统的剖析
从分页注意力、连续批处理、前缀缓存、推测解码(specdec)等,到大规模多 GPU、多节点的动态在线服务
在这篇文章中,我将逐步介绍构成现代高吞吐 LLM 推理系统的所有核心系统组件与高级特性。具体地,我会对 vLLM [1] 的工作原理进行拆解分析。
本文是一个系列的第一篇。它先宏观铺开,再逐层深入细节(采用倒金字塔式的写作方式),让你能够建立起对完整系统的准确高层心智模型,而不会被细枝末节淹没。
后续文章将深入具体的子系统。
本文分为五个部分:
- LLM 引擎与引擎核心:vLLM 基础(调度、分页注意力、连续批处理等)
- 高级特性:分块预填充、前缀缓存、引导式与推测式解码、解聚的 P/D
- 扩展规模:从单 GPU 到多 GPU 执行
- 服务层:分布式 / 并发的 Web 脚手架
- 基准测试与自动调优:衡量延迟与吞吐
📝 说明
- 分析基于 commit 42172ad(2025 年 8 月 9 日)。
- 目标读者:任何对最先进 LLM 引擎如何运作感到好奇的人,以及有意参与 vLLM、SGLang 等项目贡献的人。
- 我将聚焦于 V1 引擎。我也研究过 V0(现已弃用),它对理解项目的演进很有价值,许多概念仍然延续了下来。
- 关于 LLM 引擎 / 引擎核心的第一节可能略显枯燥/繁杂——但博客的其余部分有大量示例与图示。:)
LLM 引擎与引擎核心
LLM 引擎是 vLLM 的基本构建模块。仅凭它本身,就已经能够实现高吞吐推理——但仅限于离线场景。你还无法将其通过网络提供给客户使用。
我们将使用下面的离线推理片段作为贯穿全文的示例(改编自 basic.py)。
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
📝 环境变量:
VLLM_USE_V1="1"# 我们使用的是 V1 引擎VLLM_ENABLE_V1_MULTIPROCESSING="0"# 我们以单进程方式运行
该配置具有以下特征:
- 离线(没有 Web / 分布式系统脚手架)
- 同步(所有执行都发生在单个阻塞进程中)
- 单 GPU(没有数据/模型/流水线/专家并行;DP/TP/PP/EP = 1)
- 使用标准 Transformer [2](支持像 Jamba 这样的混合模型需要更复杂的混合 KV 缓存内存分配器)
从这里出发,我们将逐步构建出一个在线、异步、多 GPU、多节点的推理系统——但服务的仍然是标准 Transformer。
在这个示例中我们做了两件事,我们:
- 实例化一个引擎
- 在其上调用
generate,从给定提示中采样
让我们开始分析构造函数。
LLM 引擎构造函数
引擎的主要组件包括:
- vLLM 配置(包含用于配置模型、缓存、并行度等的所有旋钮)
- 处理器(通过校验、分词和处理,将原始输入转换为
EngineCoreRequests) - 引擎核心客户端(在我们的运行示例中,我们使用的是
InprocClient,它基本等同于EngineCore;我们将逐步构建到支持大规模服务的DPLBAsyncMPClient) - 输出处理器(将原始
EngineCoreOutputs转换为用户看到的RequestOutput)
📝 注意: 随着 V0 引擎被弃用,类名和细节可能会发生变化。我将强调核心思想,而非精确的签名。我会抽象掉其中一部分(但并非全部)细节。
引擎核心本身由若干子组件构成:
- 模型执行器(驱动模型的前向传播,我们当前处理的是
UniProcExecutor,它在单个 GPU 上拥有单个Worker进程)。我们将逐步构建到支持多 GPU 的MultiProcExecutor - 结构化输出管理器(用于引导式解码——我们稍后介绍)
- 调度器(决定哪些请求进入下一步引擎步骤)——它进一步包含:
- 策略设置——可以是 FCFS(先到先服务)或 priority(优先级,高优先级请求优先被服务)
waiting和running队列- KV 缓存管理器——分页注意力 [3] 的核心
KV 缓存管理器维护一个 free_block_queue——一个可用 KV 缓存块的池子(数量通常达数十万级别,取决于显存大小和块大小)。在分页注意力中,这些块充当索引结构,将 token 映射到它们已计算好的 KV 缓存块。
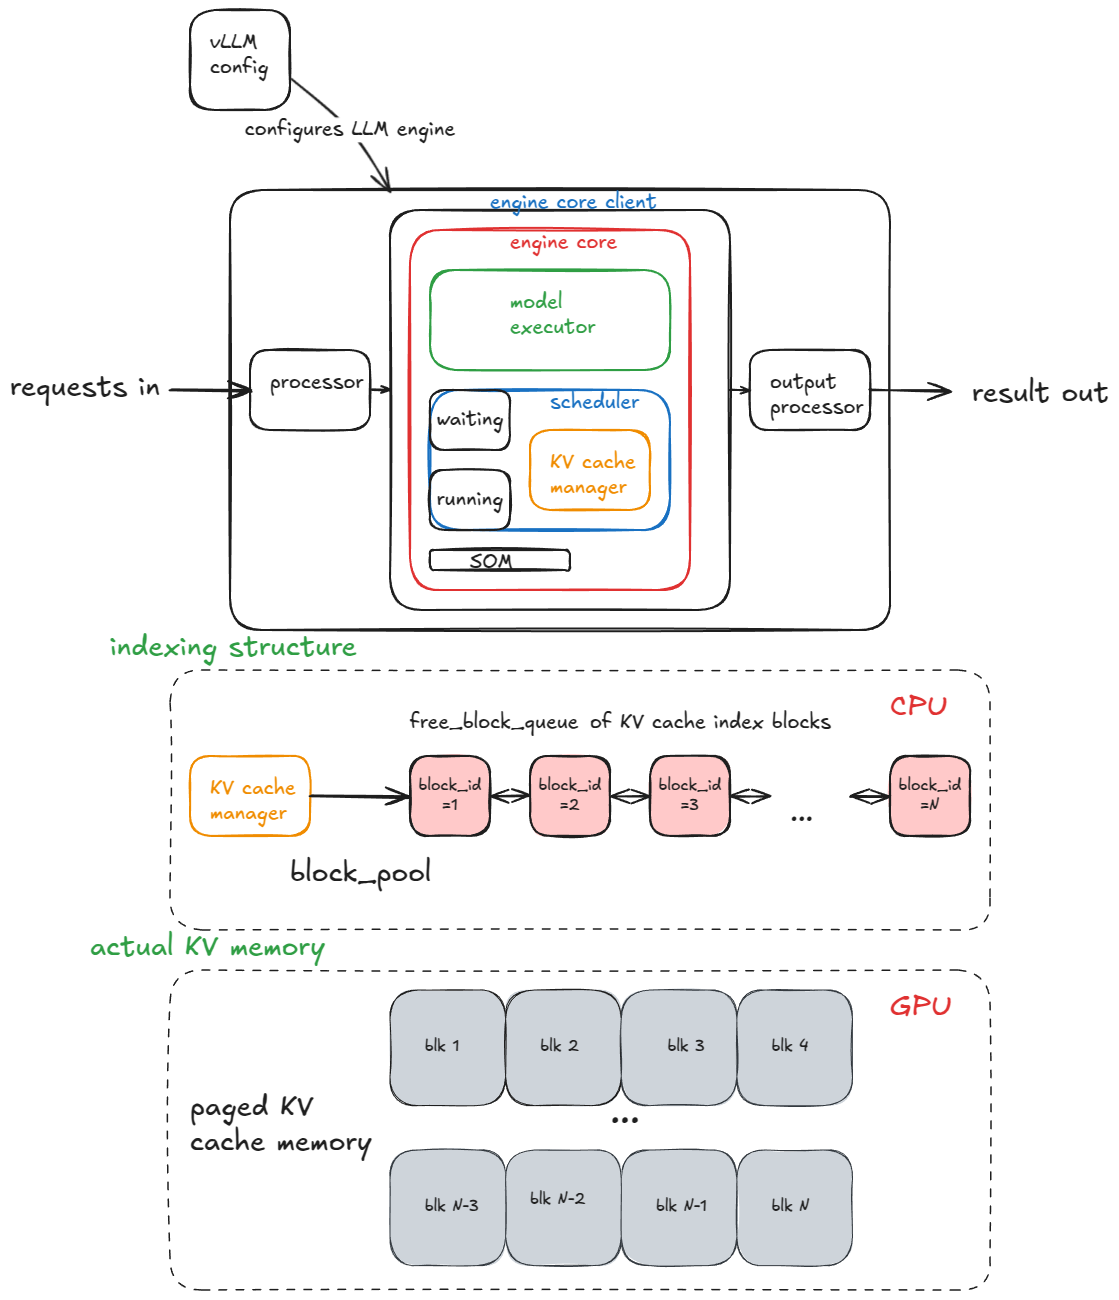
本节描述的核心组件及其关系
标准 Transformer 层(非 MLA [4])的块大小计算如下:
2 (key/value) * block_size (默认=16) * num_kv_heads * head_size * dtype_num_bytes (例如 bf16 对应 2 字节)
在模型执行器构建过程中,会创建一个 Worker 对象,并执行三个关键步骤。(稍后,在 MultiProcExecutor 中,这些相同的步骤会在不同 GPU 上的每个 worker 进程中独立运行。)
- 初始化设备:
- 为 worker 分配一个 CUDA 设备(例如 "cuda:0"),并检查模型 dtype 是否被支持(例如 bf16)
- 根据请求的
gpu_memory_utilization(例如 0.8 → 总显存的 80%)验证是否有足够的显存 - 设置分布式配置(DP / TP / PP / EP 等)
- 实例化一个
model_runner(持有采样器、KV 缓存,以及input_ids、positions等前向传播缓冲区) - 实例化一个
InputBatch对象(持有 CPU 侧的前向传播缓冲区、用于 KV 缓存索引的块表、采样元数据等)
- 加载模型:
- 实例化模型架构
- 加载模型权重
- 调用
model.eval()(PyTorch 的推理模式) - 可选:对模型调用
torch.compile()
- 初始化 KV 缓存
- 获取逐层的 KV 缓存规格。历史上它始终是
FullAttentionSpec(同质 Transformer),但随着混合模型(滑动窗口、Transformer/SSM 如 Jamba)的出现,它变得更复杂(参见 Jenga [5]) - 运行一次虚拟/性能分析的(dummy/profiling)前向传播,并拍摄 GPU 内存快照,以计算可用显存能容纳多少个 KV 缓存块
- 分配、重塑并将 KV 缓存张量绑定到注意力层
- 准备注意力元数据(例如将后端设为 FlashAttention),供后续前向传播中的内核消费
- 除非提供了
--enforce-eager,否则对每一个预热(warmup)批大小都做一次虚拟运行并捕获 CUDA 图。CUDA 图将整段 GPU 工作记录成一个 DAG。之后在前向传播中,我们启动/重放预烘焙的图,从而减少内核启动开销,进而改善延迟。
- 获取逐层的 KV 缓存规格。历史上它始终是
我在这里抽象掉了很多底层细节——但这些是我现在要介绍的核心部分,因为后续章节会反复引用它们。
既然引擎已经初始化完成,让我们继续看 generate 函数。
Generate 函数
第一步是校验并将请求送入引擎。对于每个提示,我们:
- 创建一个唯一的请求 ID 并记录其到达时间
- 调用一个输入预处理器,对提示进行分词,并返回一个包含
prompt、prompt_token_ids和type(文本、token、嵌入等)的字典 - 将信息打包进
EngineCoreRequest,并附加优先级、采样参数及其他元数据 - 将请求传入引擎核心,引擎核心将其封装为
Request对象,并将状态设置为WAITING。随后该请求被加入调度器的waiting队列(FCFS 则追加到末尾,优先级模式则推入堆中)
至此引擎已被喂入数据,执行可以开始。在同步引擎示例中,这些初始提示是我们处理的唯一请求——没有机制在运行过程中注入新请求。相比之下,异步引擎支持这一点(即 连续批处理 [6]):每一步之后,新请求和旧请求都会被纳入考虑。
由于前向传播将批次扁平化为单个序列,且自定义内核能高效处理,因此即使在同步引擎中,连续批处理在本质上也是被支持的。
接下来,只要有请求需要处理,引擎就会反复调用它的 step() 函数。每个步骤包含三个阶段:
- 调度: 选择本步骤运行哪些请求(解码,和/或(分块)预填充)
- 前向传播: 运行模型并采样 token
- 后处理: 将采样得到的 token ID 追加到每个
Request,进行反分词,并检查停止条件。如果某个请求已完成,则清理(例如将其 KV 缓存块归还给free_block_queue)并提前返回输出
📝 停止条件为:
- 请求超过其长度限制(
max_model_length或其自身的max_tokens)- 采样得到的 token 是 EOS ID(除非启用了
ignore_eos——在我们想强制生成一定数量输出 token 的基准测试场景中有用)- 采样得到的 token 与采样参数中指定的任一
stop_token_ids匹配- 输出中出现停止字符串——我们将输出截断到第一个停止字符串出现的位置,并在引擎中中止该请求(注意
stop_token_ids会保留在输出中,但停止字符串不会)
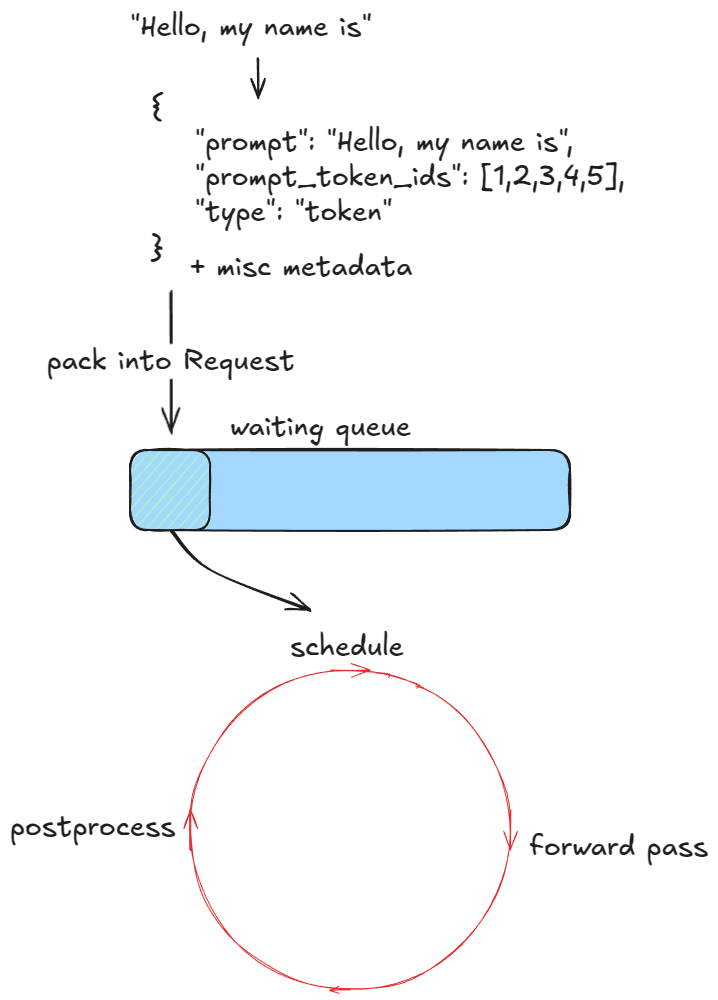
引擎循环
在流式模式下,我们会在 token 生成时即时发送中间结果,但我们现在先忽略这一点。
接下来,我们将更详细地考察调度。
调度器
推理引擎处理的负载主要有两种类型:
- 预填充(Prefill) 请求——对所有提示 token 做一次前向传播。它们通常是 计算密集(compute-bound) 的(阈值取决于硬件和提示长度)。在最后,我们从最终 token 位置的概率分布中采样一个 token。
- 解码(Decode) 请求——仅对最新一个 token 做一次前向传播。此前所有的 KV 向量都已缓存。它们是 内存带宽受限(memory-bandwidth-bound) 的,因为即便只为了计算一个 token,我们仍需加载全部 LLM 权重(以及 KV 缓存)。
在 基准测试章节 中,我们将分析所谓的 GPU 性能屋顶线(roofline)模型。那将更深入地剖析预填充 / 解码的性能特征。
得益于更巧妙的设计选择,V1 调度器可以在同一步骤中混合两种类型的请求。相比之下,V0 引擎一次只能处理预填充或解码之一。
调度器优先处理解码请求——即那些已经在 running 队列中的请求。对于每个这样的请求,它:
- 计算要生成的新 token 数量(并不总为 1,因为推测解码和异步调度的存在——稍后详述)。
- 调用 KV 缓存管理器的
allocate_slots函数(详见下文)。 - 从 token 预算中减去第 1 步的 token 数量,从而更新 token 预算。
之后,它处理来自 waiting 队列的预填充请求,它:
- 获取已计算的块数量(如果禁用了前缀缓存则返回 0——我们稍后介绍)。
- 调用 KV 缓存管理器的
allocate_slots函数。 - 将该请求从 waiting 弹出并移入 running,将其状态设为
RUNNING。 - 更新 token 预算。
现在让我们看看 allocate_slots 做了什么,它:
- 计算块数量——确定必须分配多少个新 KV 缓存块(
n)。默认每个块存储 16 个 token。例如,若一个预填充请求有 17 个新 token,我们需要ceil(17/16) = 2个块。 - 检查可用性——如果管理器的池中块数量不足,则提前退出。根据是解码还是预填充请求,引擎可能会尝试通过驱逐低优先级请求(调用
kv_cache_manager.free,将 KV 块归还给块池)来进行重计算式抢占(V0 支持交换式抢占),或者跳过调度并继续执行。 - 分配块——通过 KV 缓存管理器的协调器,从块池(前面提到的
free_block_queue双向链表)中取出前n个块。存入req_to_blocks,即把每个request_id映射到其 KV 缓存块列表的字典。
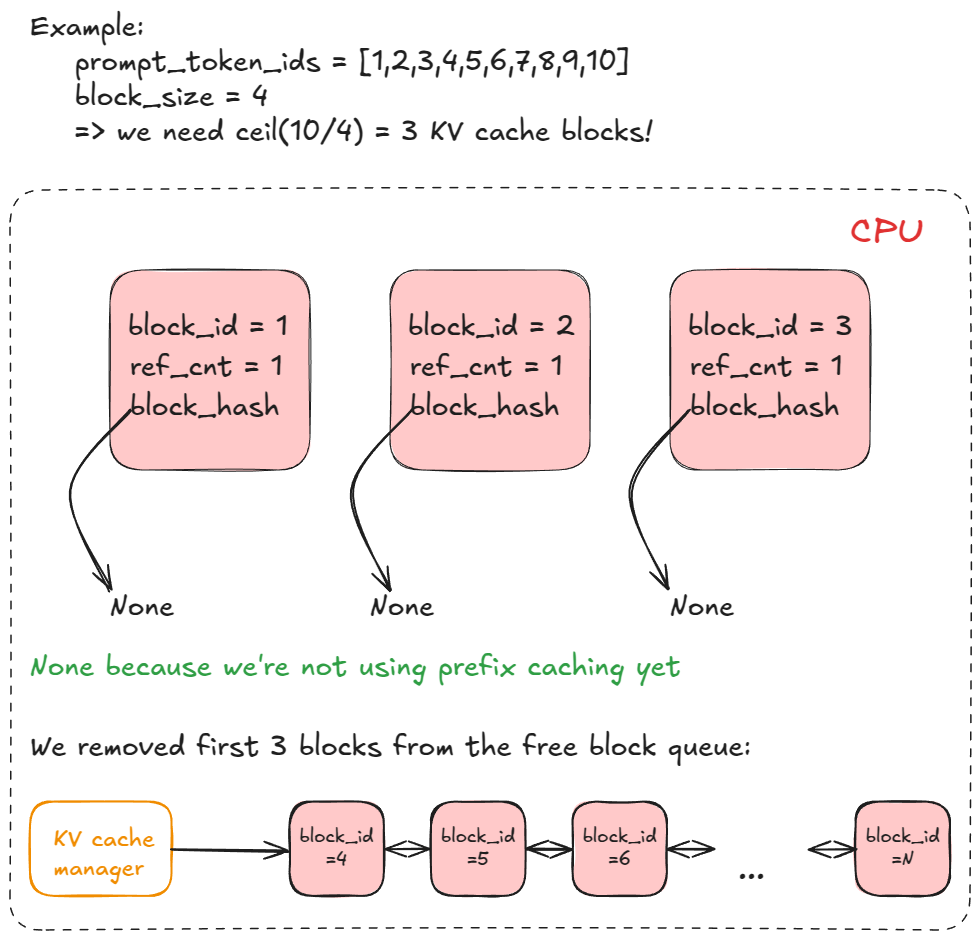
KV 缓存块列表
我们终于可以进行前向传播了!
运行前向传播
我们调用模型执行器的 execute_model,它委托给 Worker,Worker 再委托给模型运行器(model runner)。
主要步骤如下:
- 更新状态——从
input_batch中剪枝已完成请求;更新与前向传播相关的杂项元数据(例如每个请求用于索引分页 KV 缓存内存的 KV 缓存块)。 - 准备输入——将缓冲区从 CPU 拷贝到 GPU;计算位置;构建
slot_mapping(示例中详述);构造注意力元数据。 - 前向传播——使用自定义的分页注意力内核运行模型。所有序列被扁平化并拼接成一条长的"超级序列"。位置索引和注意力掩码确保每个序列只关注自身的 token,从而实现无右侧填充(right-padding)的连续批处理。
- 收集末 token 状态——提取每个序列最终位置的隐藏状态并计算 logits。
- 采样——根据采样配置(贪心、temperature、top-p、top-k 等)从计算出的 logits 中采样 token。
前向传播步骤本身有两种执行模式:
- 即时(Eager)模式——在启用即时执行时运行标准 PyTorch 前向传播。
- "捕获(Captured)"模式——在未强制即时执行时,执行/重放预先捕获的 CUDA Graph(记得我们在引擎构建的初始化 KV 缓存步骤中捕获了这些图)。
下面是一个具体示例,应能让你看清连续批处理与分页注意力:
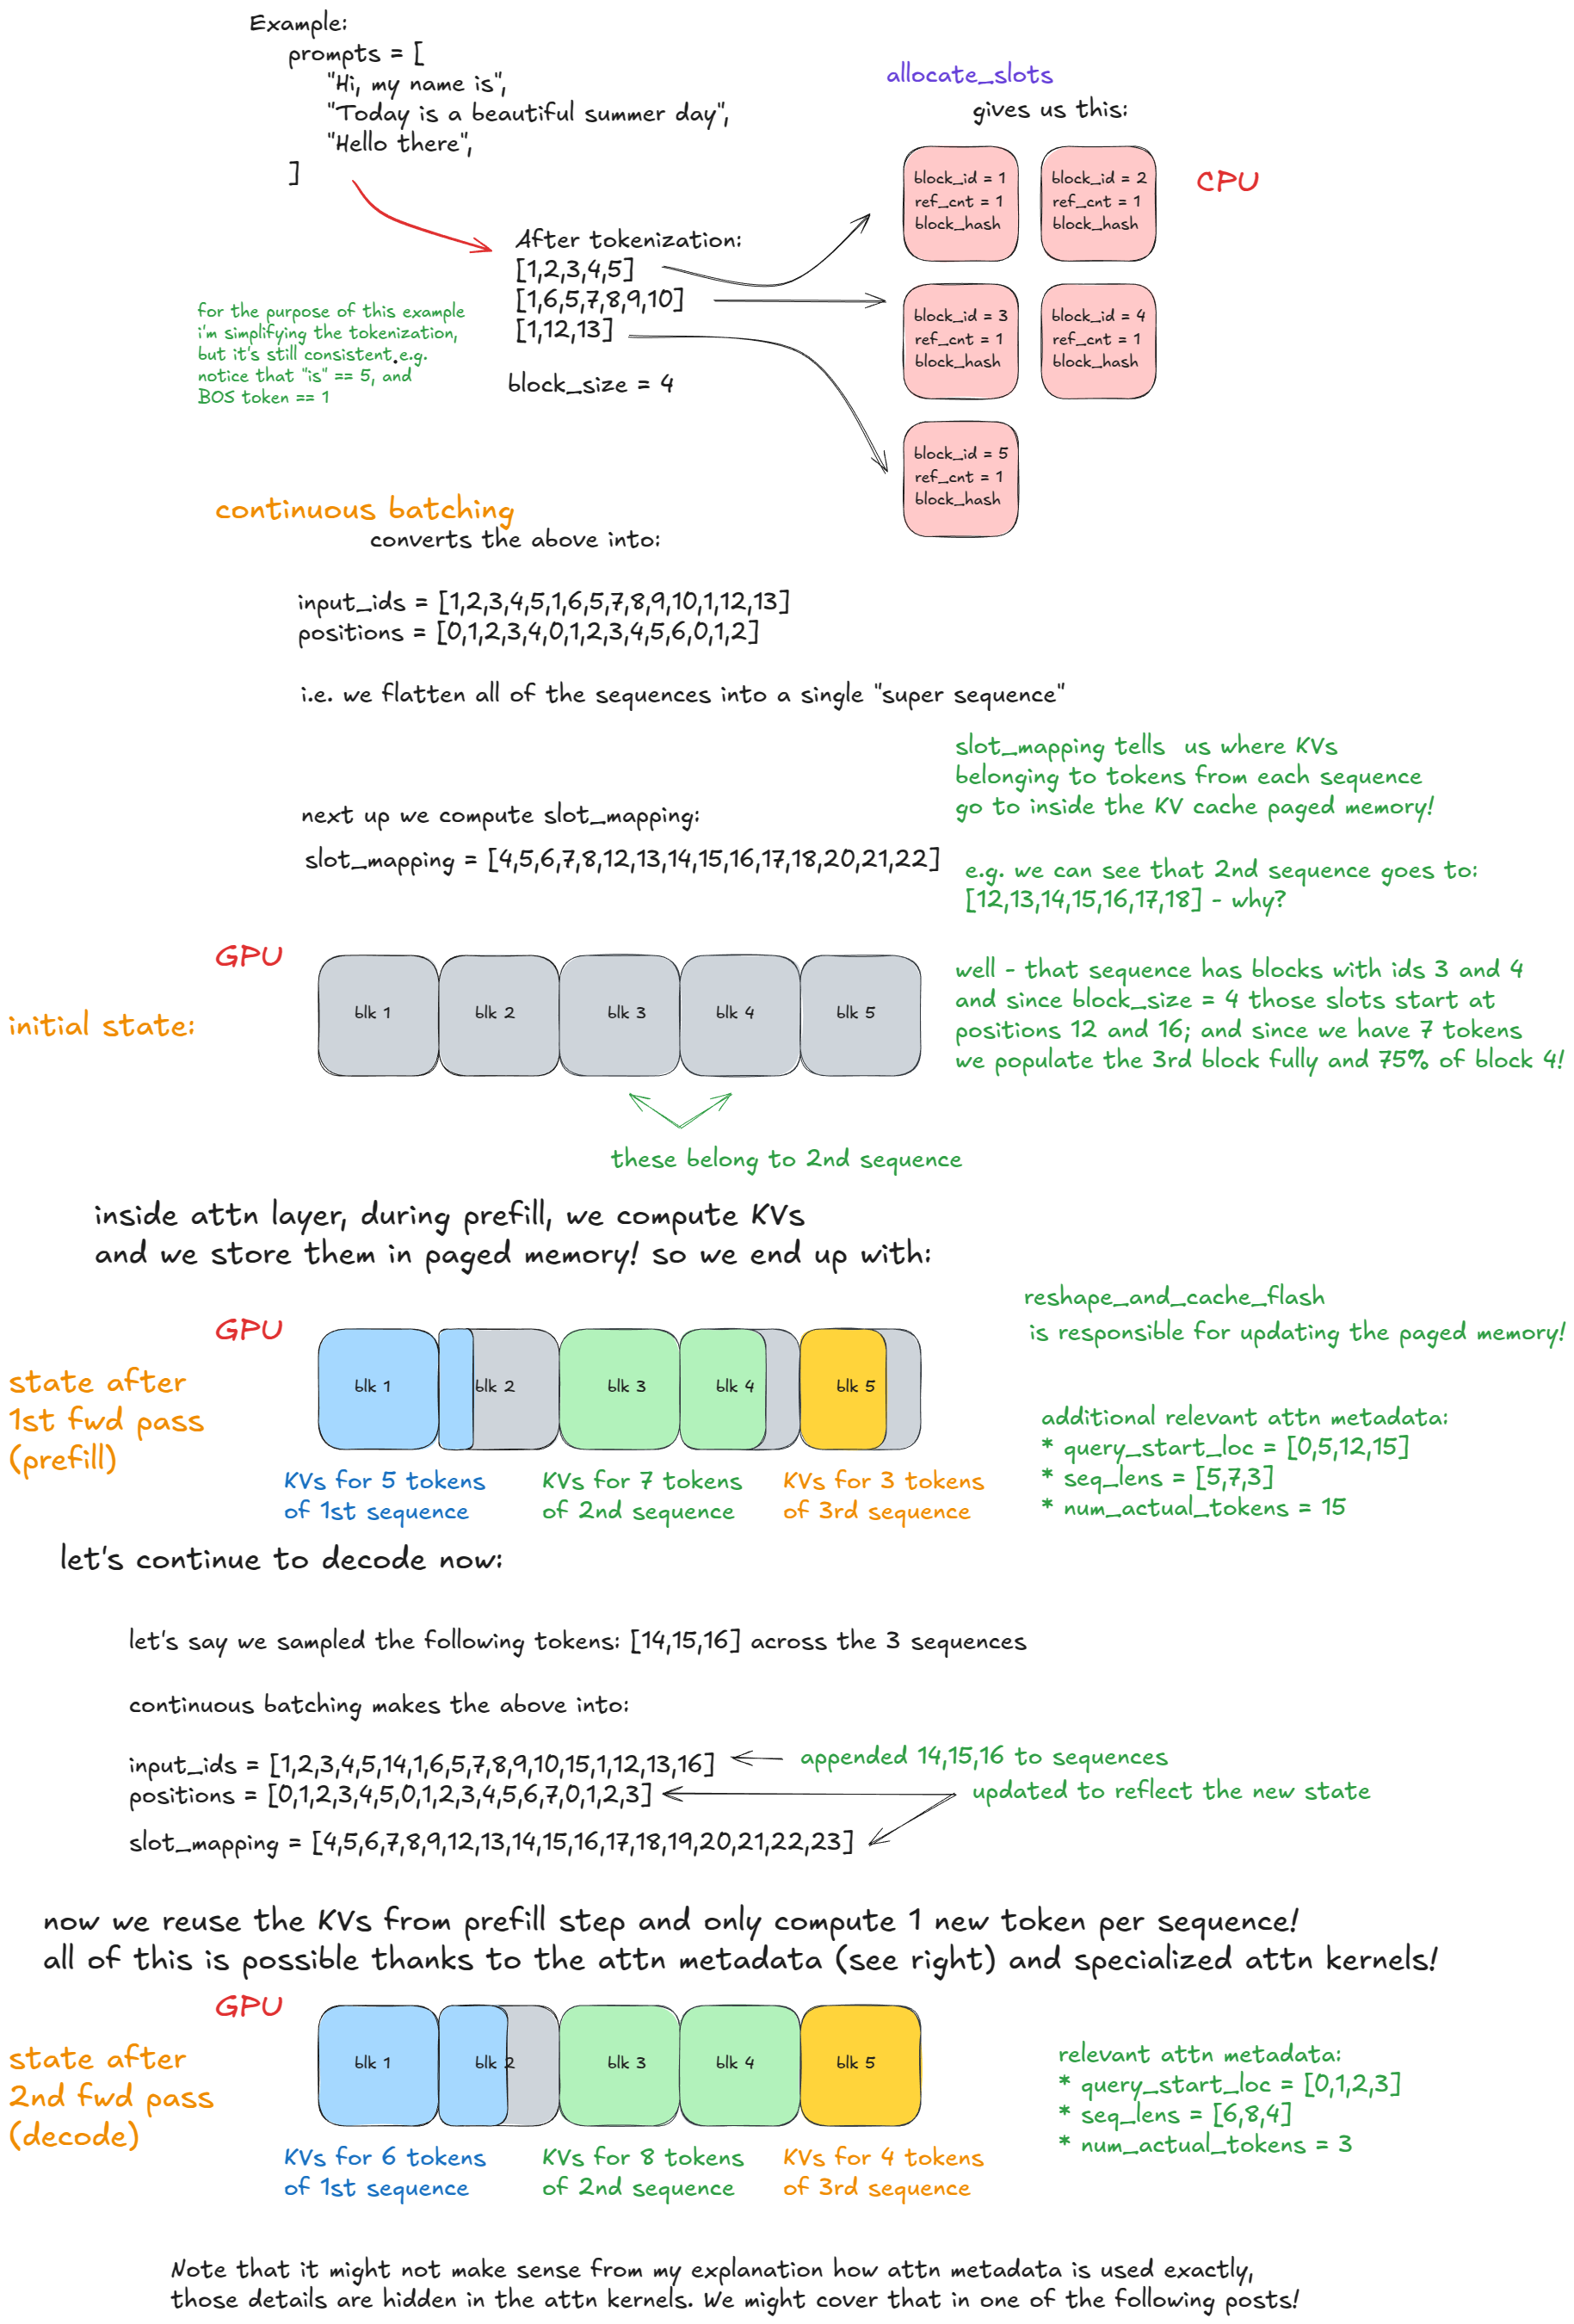
前向传播:连续批处理与分页注意力
高级特性——扩展核心引擎逻辑
在基本引擎流程就位后,我们现在可以看看高级特性。
我们已经讨论过抢占、分页注意力和连续批处理。
接下来,我们将深入:
- 分块预填充
- 前缀缓存
- 引导式解码(通过语法约束的有限状态机)
- 推测解码
- 解聚的 P/D(预填充/解码)
分块预填充
分块预填充是一种通过将长提示的预填充步骤拆分为更小块来处理长提示的技术。如果没有它,我们可能会遇到单个超长请求独占一个引擎步骤,从而阻止其他预填充请求运行的情况。那会推迟所有其他请求并增加它们的延迟。
例如,令每个块包含 n(=8)个 token,用 "-" 分隔的小写字母标记。一个长提示 P 可能形如 x-y-z,其中 z 是一个不完整的块(例如 2 个 token)。那么执行 P 的完整预填充将需要 ≥ 3 个引擎步骤(如果未被安排在某一步中执行,则可能出现 > 的情况),并且只有在最后一个分块预填充步骤中,我们才会采样一个新 token。
下面是同一个示例的图示:
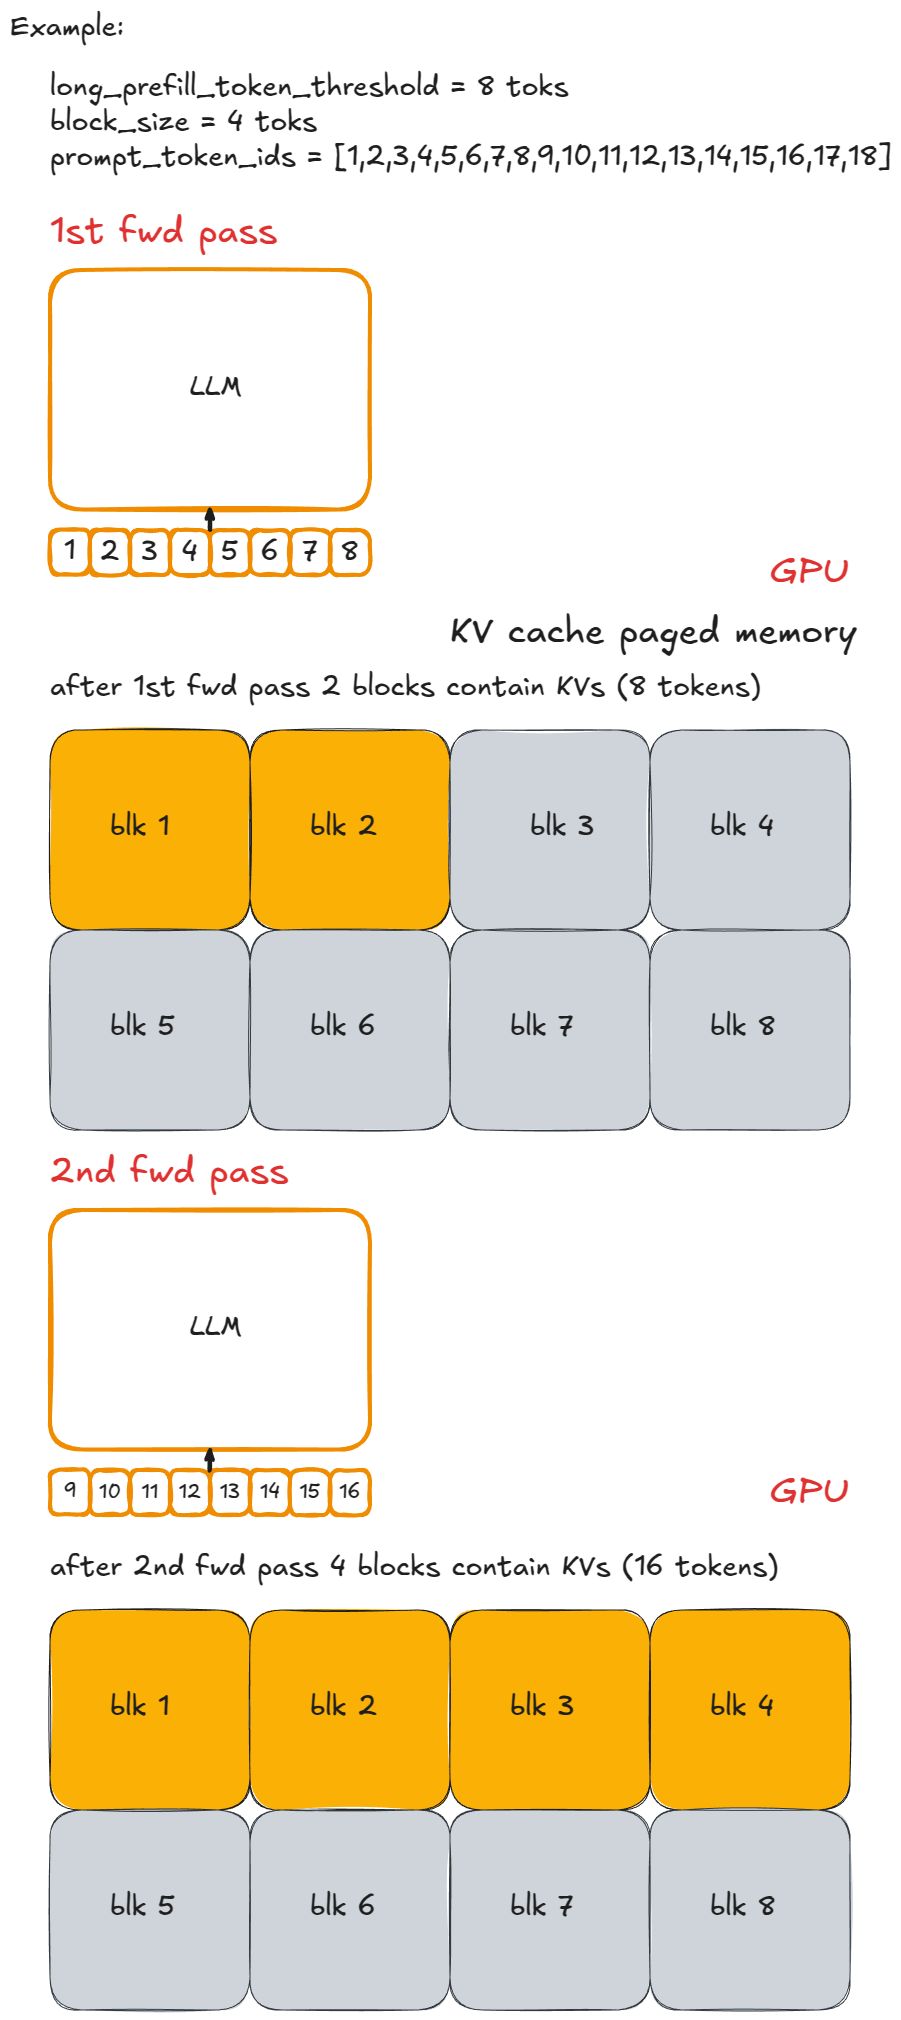
实现很直接:限制每步的新 token 数量。如果请求的数量超过 long_prefill_token_threshold,则将其重置为该值。底层的索引逻辑(前面已描述)会处理其余部分。
在 vLLM V1 中,你可以通过将 long_prefill_token_threshold 设为正整数来启用分块预填充。(从技术上讲,无论是否这样设置,只要提示长度超过 token 预算,我们就会截断它并运行分块预填充。)
前缀缓存
为了解释前缀缓存的工作原理,让我们拿最初的代码示例稍作修改:
from vllm import LLM, SamplingParams

long_prefix = "<一段被编码为超过 block_size 个 token 的文本>"

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(long_prefix + prompts[0], sampling_params)
    outputs = llm.generate(long_prefix + prompts[1], sampling_params)

if __name__ == "__main__":
    main()
前缀缓存避免对多个提示在开头共享的 token 重复计算——这正是 前缀(prefix) 的由来。
关键部分在于 long_prefix:它被定义为任何长于一个 KV 缓存块(默认 16 个 token)的前缀。为了简化示例,我们假设 long_prefix 的长度恰好为 n x block_size(其中 n ≥ 1)。
即它与块边界完美对齐——否则我们就必须重新计算 long_prefix_len % block_size 个 token,因为我们无法缓存不完整的块。
没有前缀缓存时,每次我们处理一个带有相同 long_prefix 的新请求,都会重新计算全部 n x block_size 个 token。
有了前缀缓存,这些 token 只计算一次(它们的 KV 存储在 KV 缓存的分页内存中)然后被复用,因此只需处理新的提示 token。这会加速预填充请求(尽管对解码没有帮助)。
这在 vLLM 中是如何工作的?
在第一次 generate 调用时,在调度阶段,kv_cache_manager.get_computed_blocks 内部,引擎会调用 hash_request_tokens:
- 该函数将
long_prefix + prompts[0]拆分为 16 个 token 的块。 - 对每个完整的块,它计算一个哈希(使用内置哈希或 SHA-256,后者更慢但碰撞更少)。该哈希结合了前一个块的哈希、当前 token 以及可选元数据。
- 可选元数据包括:多模态哈希(MM hash)、LoRA ID、缓存盐值(cache salt,注入第一个块的哈希中,确保只有携带该缓存盐值的请求才能复用块)。
- 每个结果存储为一个
BlockHash对象,包含哈希及其 token ID。我们返回一个块哈希列表。
该列表被存储在 self.req_to_block_hashes[request_id] 中。
接下来,引擎调用 find_longest_cache_hit 来检查这些哈希中是否有任何一个已存在于 cached_block_hash_to_block 中。在第一个请求时,未找到任何命中。
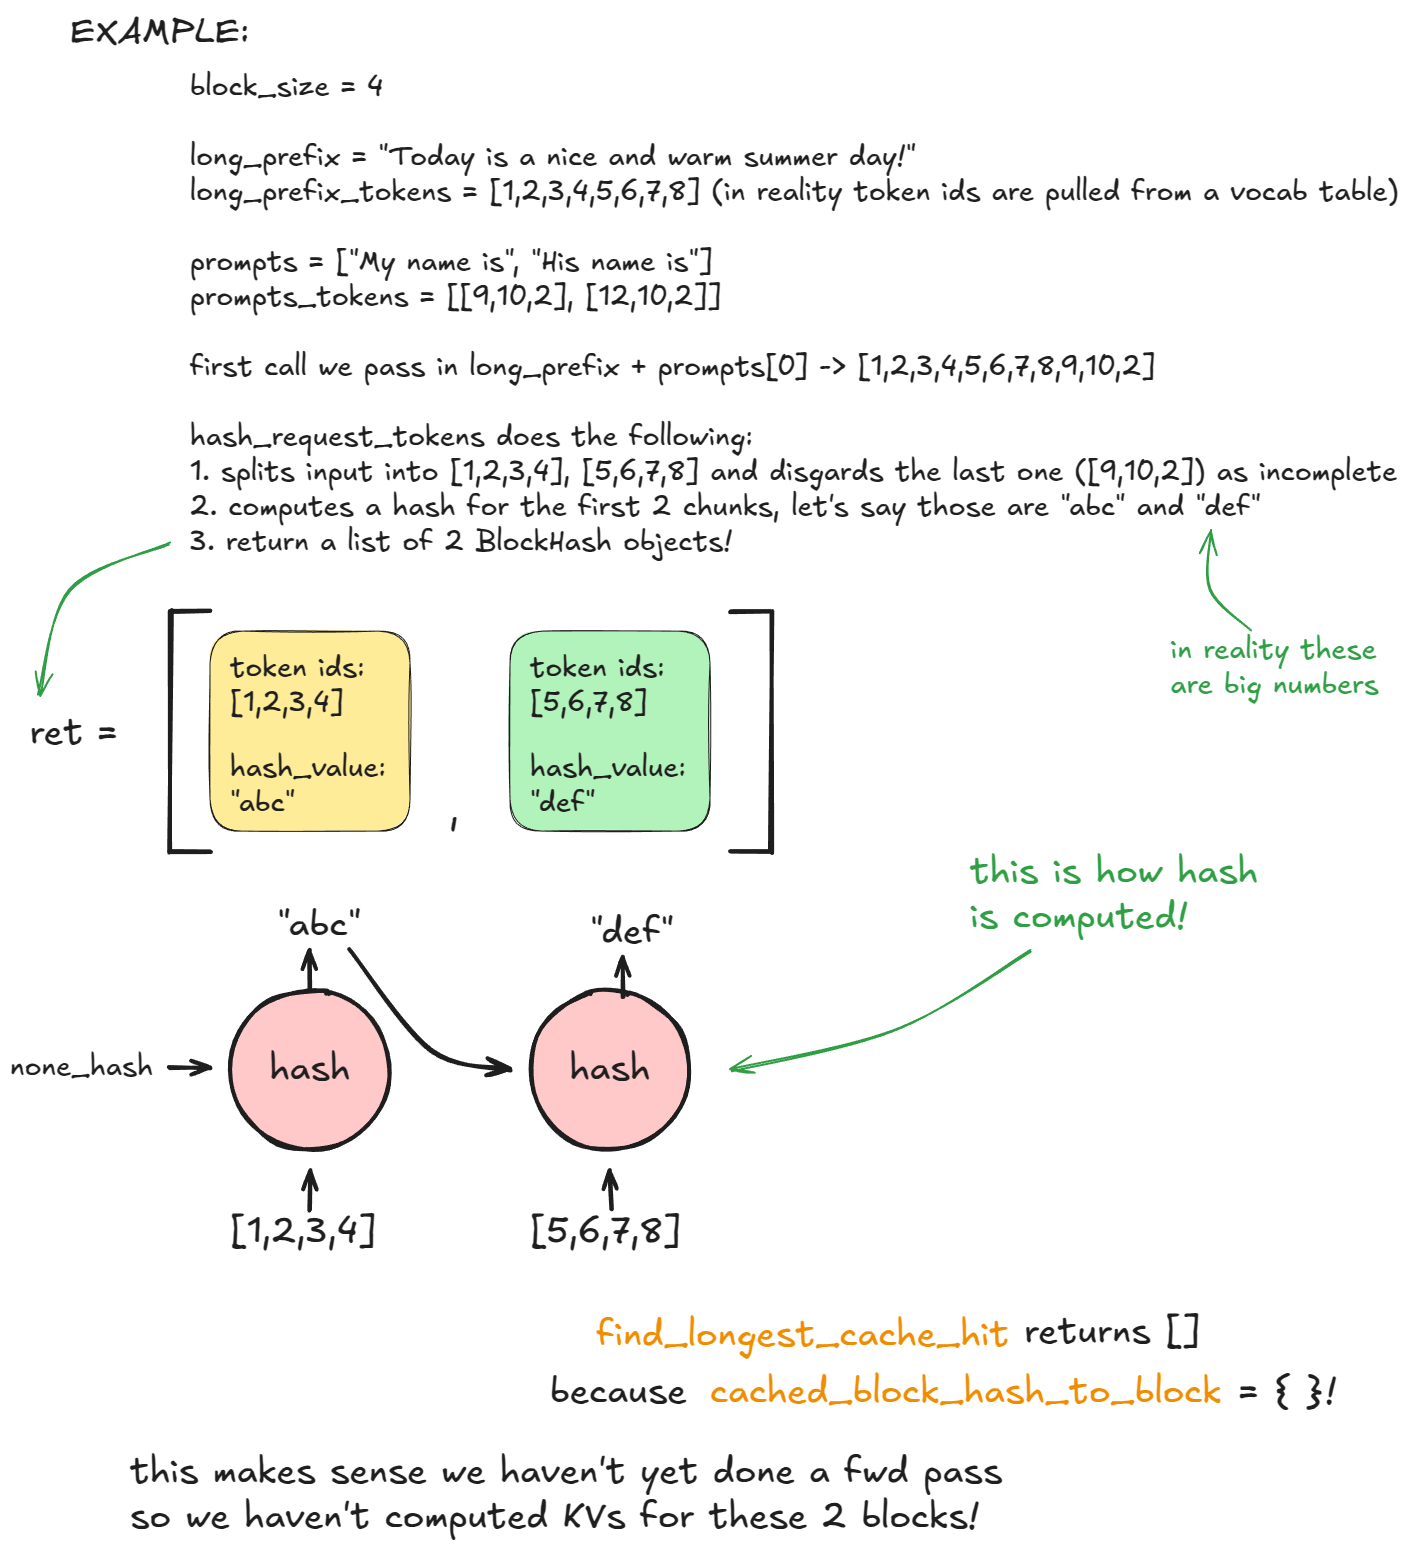
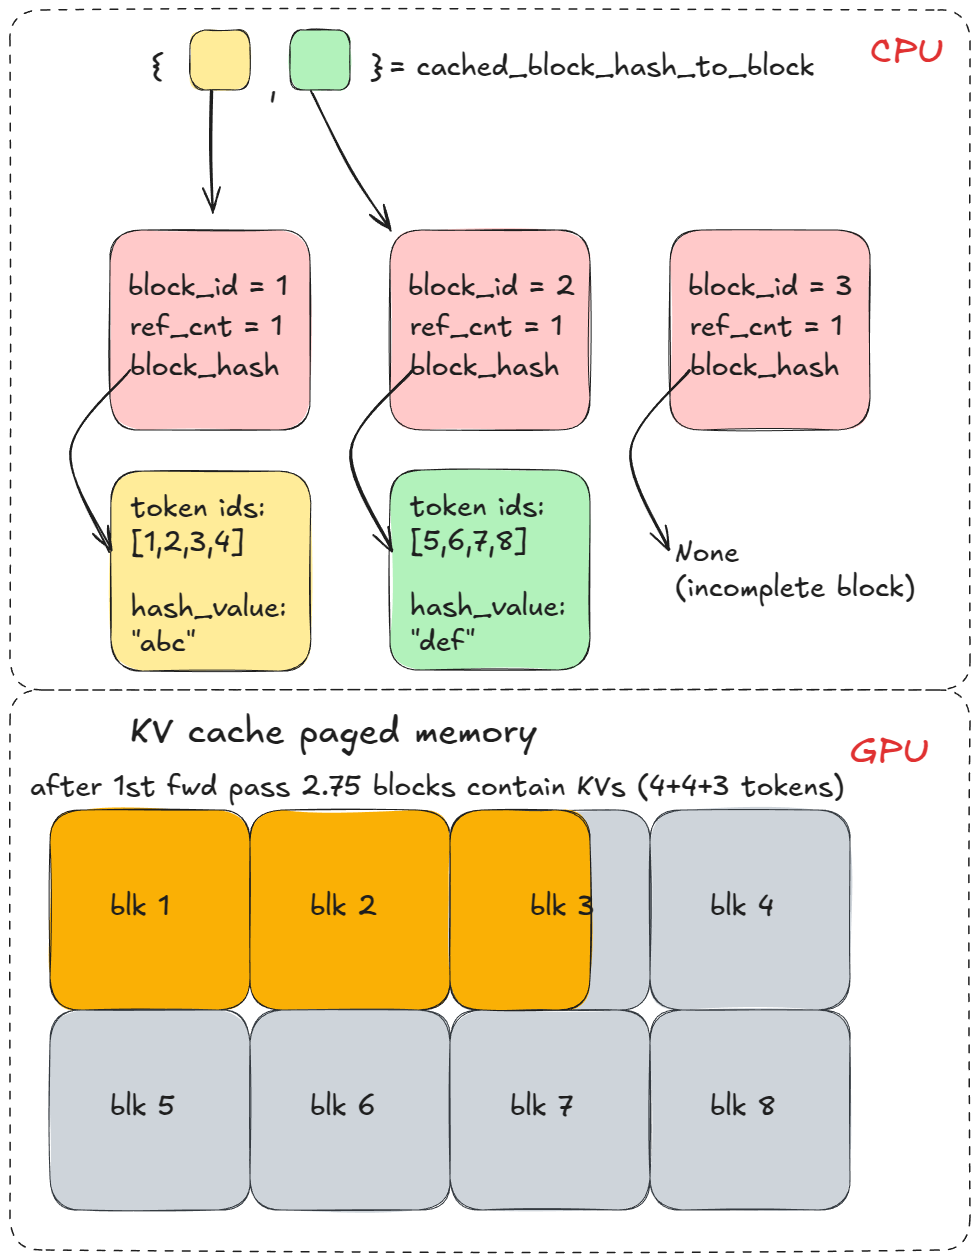
然后我们调用 allocate_slots,它会调用 coordinator.cache_blocks,将新的 BlockHash 条目与已分配的 KV 块关联,并记录到 cached_block_hash_to_block 中。
之后,前向传播会将 KV 填入到我们上面分配的 KV 缓存块所对应的分页 KV 缓存内存中。
经过多个引擎步骤后,它会分配更多 KV 缓存块,但这对我们的示例没有影响,因为前缀在 long_prefix 之后立即发生了分叉。
在第二次使用相同前缀的 generate 调用时,步骤 1-3 重复,但现在 find_longest_cache_hit 找到了所有 n 个块的匹配(通过线性搜索)。引擎可以直接复用那些 KV 块。
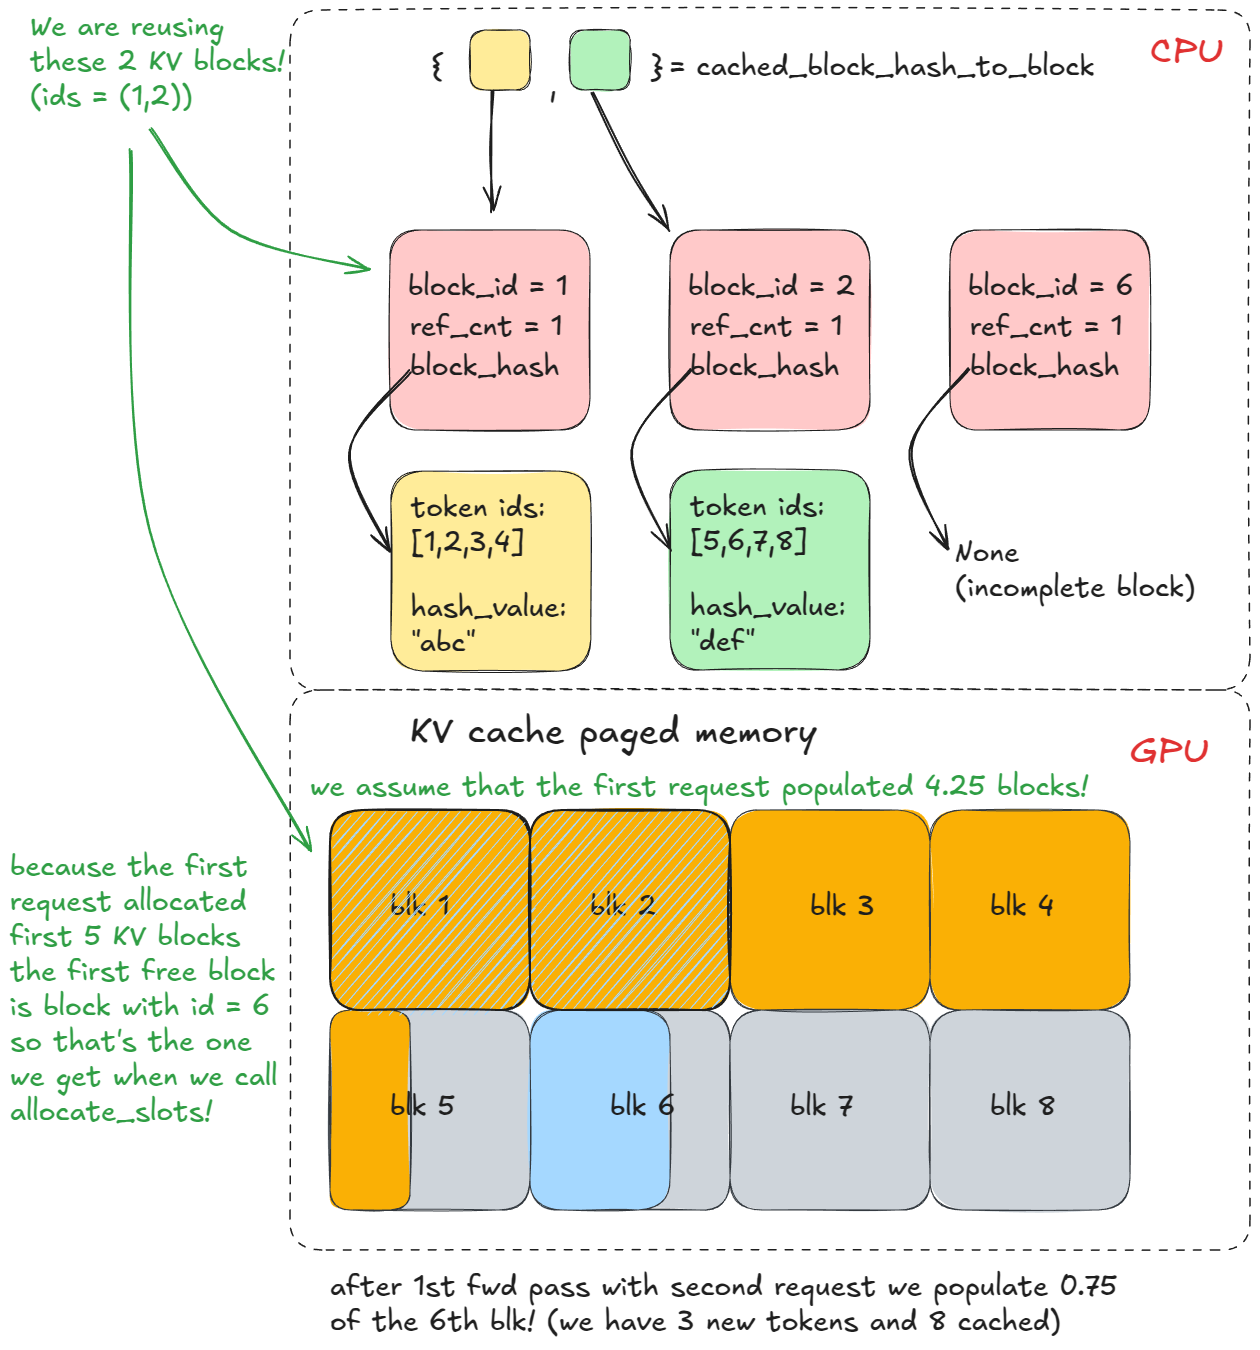
如果原始请求仍然存活,那些块的引用计数会递增(例如增至 2)。在本示例中,第一个请求已经完成,因此这些块被释放回池中,引用计数重置为 0。由于我们能够从 cached_block_hash_to_block 中取回它们,我们就知道它们仍然有效(KV 缓存管理器的逻辑正是这样设计的),所以我们只需再次将它们从 free_block_queue 中移除。
📝 进阶说明: KV 缓存块只有在即将从
free_block_queue(从左侧弹出)重新分配,并且我们发现该块仍然关联着一个哈希、且存在于cached_block_hash_to_block中时,才会变为无效。在那一刻,我们清除该块的哈希,并将其条目从cached_block_hash_to_block中移除,确保它无法通过前缀缓存被复用(至少不能用于那个旧前缀)。
这就是前缀缓存的要点:不要重复计算你已经见过的那些前缀——直接复用它们的 KV 缓存即可!
如果你理解了该示例,你也就理解了分页注意力的工作原理。
前缀缓存默认启用。要禁用它:enable_prefix_caching = False。
引导式解码(FSM)
引导式解码是一种技术:在每一步解码时,logits 受到基于语法的有限状态机约束。这确保只有语法允许的 token 才能被采样。
这是一个强大的机制:你可以强制约束从正则文法(乔姆斯基 3 型,例如任意正则表达式)一直到上下文无关文法(2 型,覆盖大多数编程语言)的任何内容。
为了让它不那么抽象,让我们基于前面的代码,从最简单的示例开始:
from vllm import LLM, SamplingParams
from vllm.sampling_params import GuidedDecodingParams

prompts = [
    "This sucks",
    "The weather is beautiful",
]

guided_decoding_params = GuidedDecodingParams(choice=["Positive", "Negative"])
sampling_params = SamplingParams(guided_decoding=guided_decoding_params)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
在我给出的玩具示例中(假设是字符级分词):在预填充阶段,FSM 屏蔽 logits,使得只有 "P" 或 "N" 是可行的。如果采样到 "P",FSM 转移到 "Positive" 分支;下一步只允许 "o",依此类推。
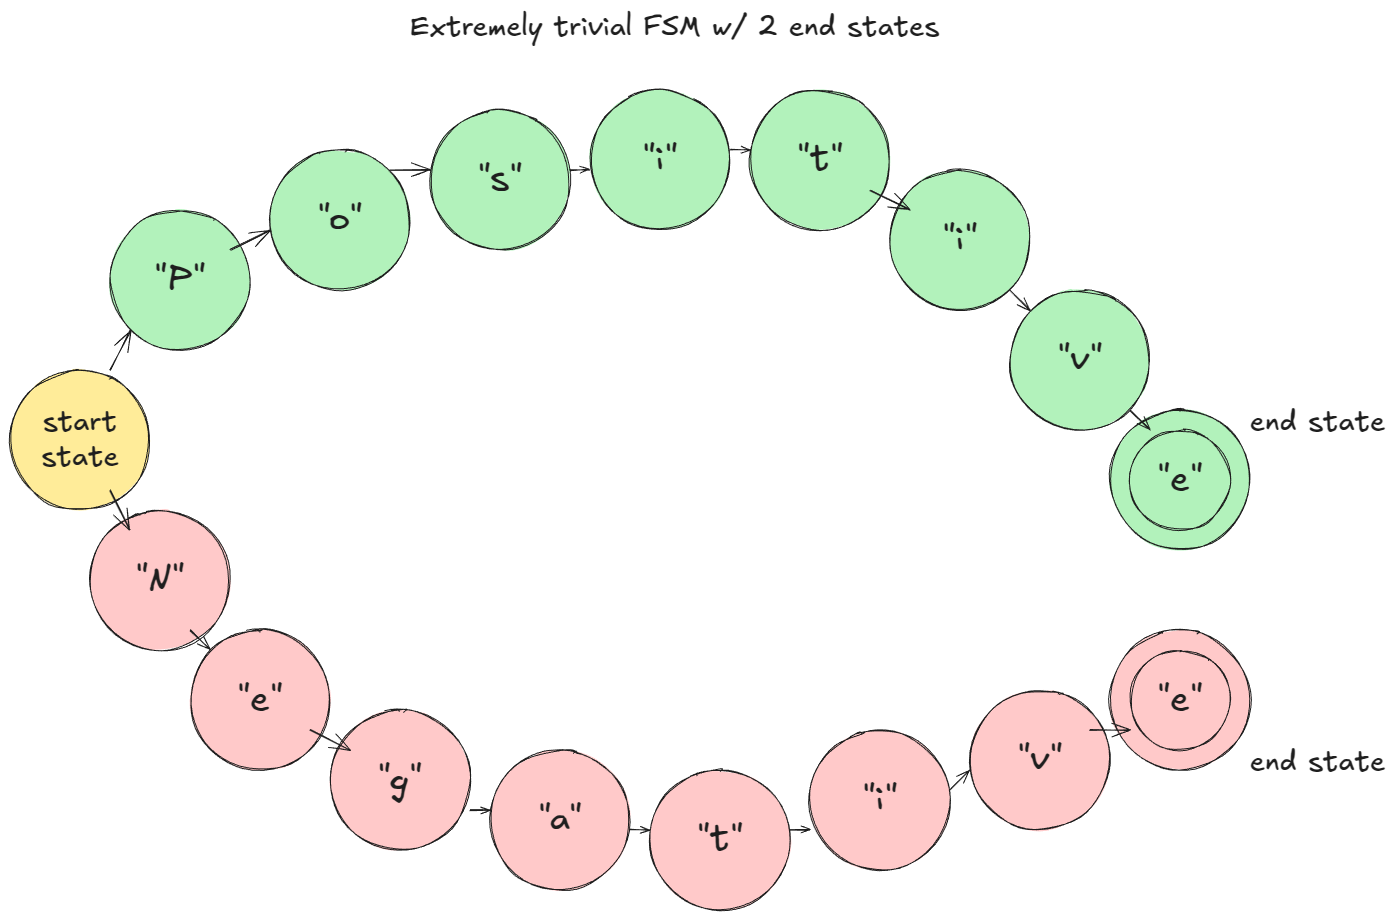
玩具示例 FSM
这在 vLLM 中如何工作:
- 在 LLM 引擎构建时,创建一个
StructuredOutputManager;它可以访问分词器,并维护一个_grammar_bitmask张量。 - 当添加请求时,其状态被设为
WAITING_FOR_FSM,并由grammar_init选择后端编译器(例如xgrammar[7];注意后端是第三方代码)。 - 该请求的语法被异步编译。
- 在调度期间,如果异步编译已完成,状态切换为
WAITING,并将request_id加入structured_output_request_ids;否则将其放入skipped_waiting_requests,在下一步引擎步骤中重试。 - 在调度循环之后(仍在调度内部),如果存在 FSM 请求,
StructuredOutputManager会要求后端准备/更新_grammar_bitmask。 - 在前向传播产生 logits 后,
xgr_torch_compile的函数将位掩码扩展到词表大小(32 倍扩展比,因为我们使用 32 位整数),并将不允许的 logits 掩码为 –∞。 - 在采样下一个 token 后,通过
accept_tokens推进该请求的 FSM。直观上,我们移动到 FSM 图上的下一个状态。
第 6 步值得进一步说明。
如果 vocab_size = 32,_grammar_bitmask 是一个单独的整数;其二进制表示编码了哪些 token 被允许("1")或被禁止("0")。例如,"101…001" 扩展为长度为 32 的数组 [1, 0, 1, …, 0, 0, 1];为 0 的位置其 logits 被设为 –∞。对于更大的词表,使用多个 32 位字并相应地进行扩展/拼接。后端(例如 xgrammar)负责利用当前 FSM 状态生成这些位模式。
📝 注意: 这里的大部分复杂性都隐藏在 xgrammar 之类的第三方库中。
下面是一个更简单的示例,使用 vocab_size = 8 和 8 位整数(给喜欢我的图示的读者):
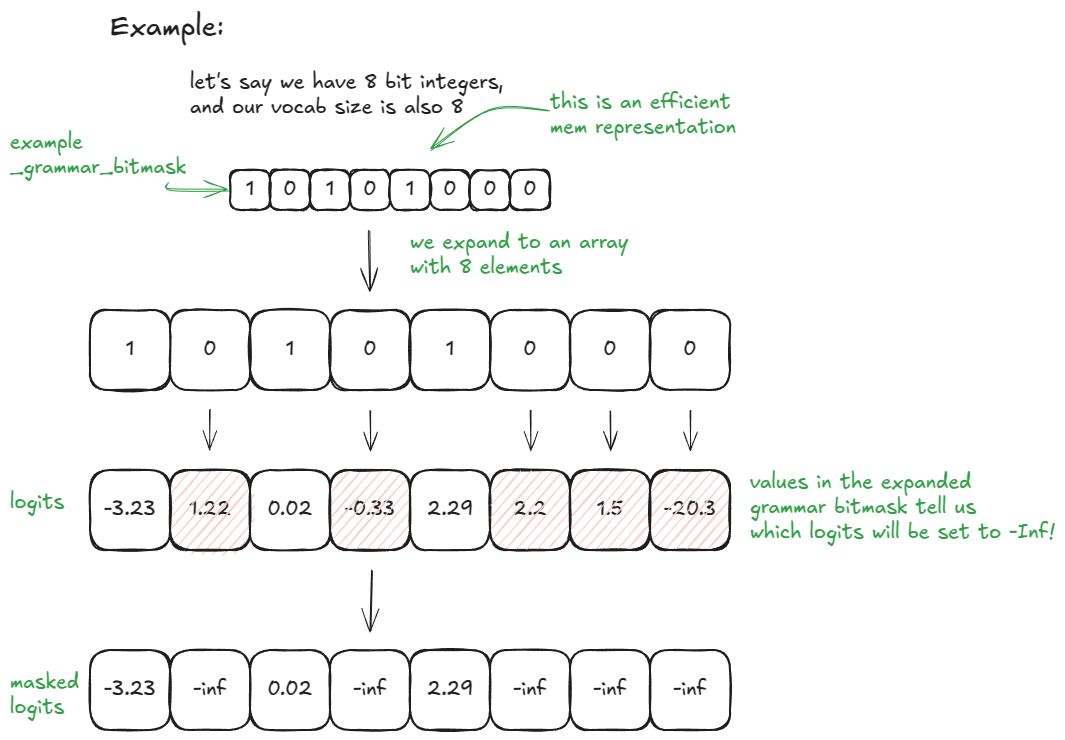
玩具示例
你可以在 vLLM 中通过传入所需的 guided_decoding 配置来启用它。
推测解码
在自回归生成中,每个新 token 都需要大型 LM 的一次前向传播。这很昂贵——每一步都要重新加载并应用全部模型权重,却只为了计算一个 token!(假设批大小为 1,一般情况是 B)
推测解码 [8] 通过引入一个更小的草案(draft)LM 来加速。草案以低成本提出 k 个 token。但我们最终并不想从较小的模型采样——它只是用来猜测候选续写。大型模型仍然决定什么是有效的。
步骤如下:
- 起草(Draft): 在当前上下文上运行小模型,提出
k个 token - 验证(Verify): 在上下文 +
k个草案 token 上运行一次大型模型。这会为那k个位置生成概率,外加一个额外位置(因此我们得到k+1个候选) - 接受/拒绝(Accept/reject): 从左到右遍历
k个草案 token:- 如果大型模型对草案 token 的概率 ≥ 草案模型的概率,则接受它
- 否则,以概率
p_large(token)/p_draft(token)接受它 - 在第一个拒绝处停止,或者接受全部
k个草案 token。 - 如果所有
k个草案 token 都被接受,还可以"免费"从大型模型采样额外的第(k+1)个 token(该分布我们已经计算过了)。 - 如果发生拒绝,则在该位置创建一个新的再平衡分布(
p_large - p_draft,最小值截断为 0,归一化使和为 1),并从中采样最后一个 token。
为何有效: 尽管我们使用小模型来提出候选,接受/拒绝规则保证了在期望上,序列的分布与我们从大型模型逐个 token 采样的结果完全一致。这意味着推测解码在统计上等价于标准自回归解码——但可能快得多,因为一次大型模型前向传播最多可产出 k+1 个 token。
📝 注意: 我推荐查看 gpt-fast 以了解简单实现,以及参考 原始论文 了解数学细节及其与从完整模型采样等价的证明。
vLLM V1 不支持 LLM 草案模型方法,而是实现了更快——但精度较低——的提议方案:n-gram、EAGLE [9] 和 Medusa [10]。
各自简述如下:
- n-gram: 取最后
prompt_lookup_max个 token;在序列中寻找先前的匹配;如果找到,提出跟随该匹配之后的k个 token;否则缩小窗口并重试,直到prompt_lookup_min- 当前实现在 第一个 匹配之后返回
k个 token。引入近期性偏好并反转搜索方向(即最后一个匹配)似乎更自然?
- 当前实现在 第一个 匹配之后返回
- Eagle: 对大型 LM 进行"模型手术"——保留嵌入层和 LM head,用轻量 MLP 替换 transformer 堆叠;将其微调作为廉价的草案
- Medusa: 在大型模型顶部(LM head 之前的嵌入层之上)训练辅助线性头,以并行预测接下来
k个 token;利用这些头提出 token,比运行一个独立的小 LM 更高效
下面是在 vLLM 中使用 ngram 作为草案方法调用推测解码的方式:
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

speculative_config={
    "method": "ngram",
    "prompt_lookup_max": 5,
    "prompt_lookup_min": 3,
    "num_speculative_tokens": 3,
}

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", speculative_config=speculative_config)

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
这在 vLLM 中如何工作?
设置(引擎构建期间):
- 初始化设备:创建一个
drafter(草案模型,例如NgramProposer)和一个rejection_sampler(其中部分用 Triton 编写)。 - 加载模型:加载草案模型权重(n-gram 为空操作)。
之后在 generate 函数中(假设我们得到一个全新的请求):
- 用大型模型运行常规预填充步骤。
- 在前向传播和标准采样之后,调用
propose_draft_token_ids(k)从草案模型采样k个草案 token。 - 将它们存入
request.spec_token_ids(更新请求元数据)。 - 在下一步引擎步骤中,当请求位于 running 队列时,将
len(request.spec_token_ids)加到"新 token"计数中,使allocate_slots为前向传播预留足够的 KV 块。 - 将
spec_token_ids拷贝进input_batch.token_ids_cpu,形成(上下文 + 草案)token。 - 通过
_calc_spec_decode_metadata计算元数据(这会从input_batch.token_ids_cpu拷贝 token、准备 logits 等),然后在草案 token 上运行一次大型模型前向传播。 - 不使用从 logits 进行常规采样,而是使用
rejection_sampler从左到右进行接受/拒绝,生成output_token_ids。 - 重复步骤 2-7,直到满足停止条件。
内化这些的最佳方式是启动调试器、单步跟踪代码库,但本节希望能让你尝到一点味道。下面也是:
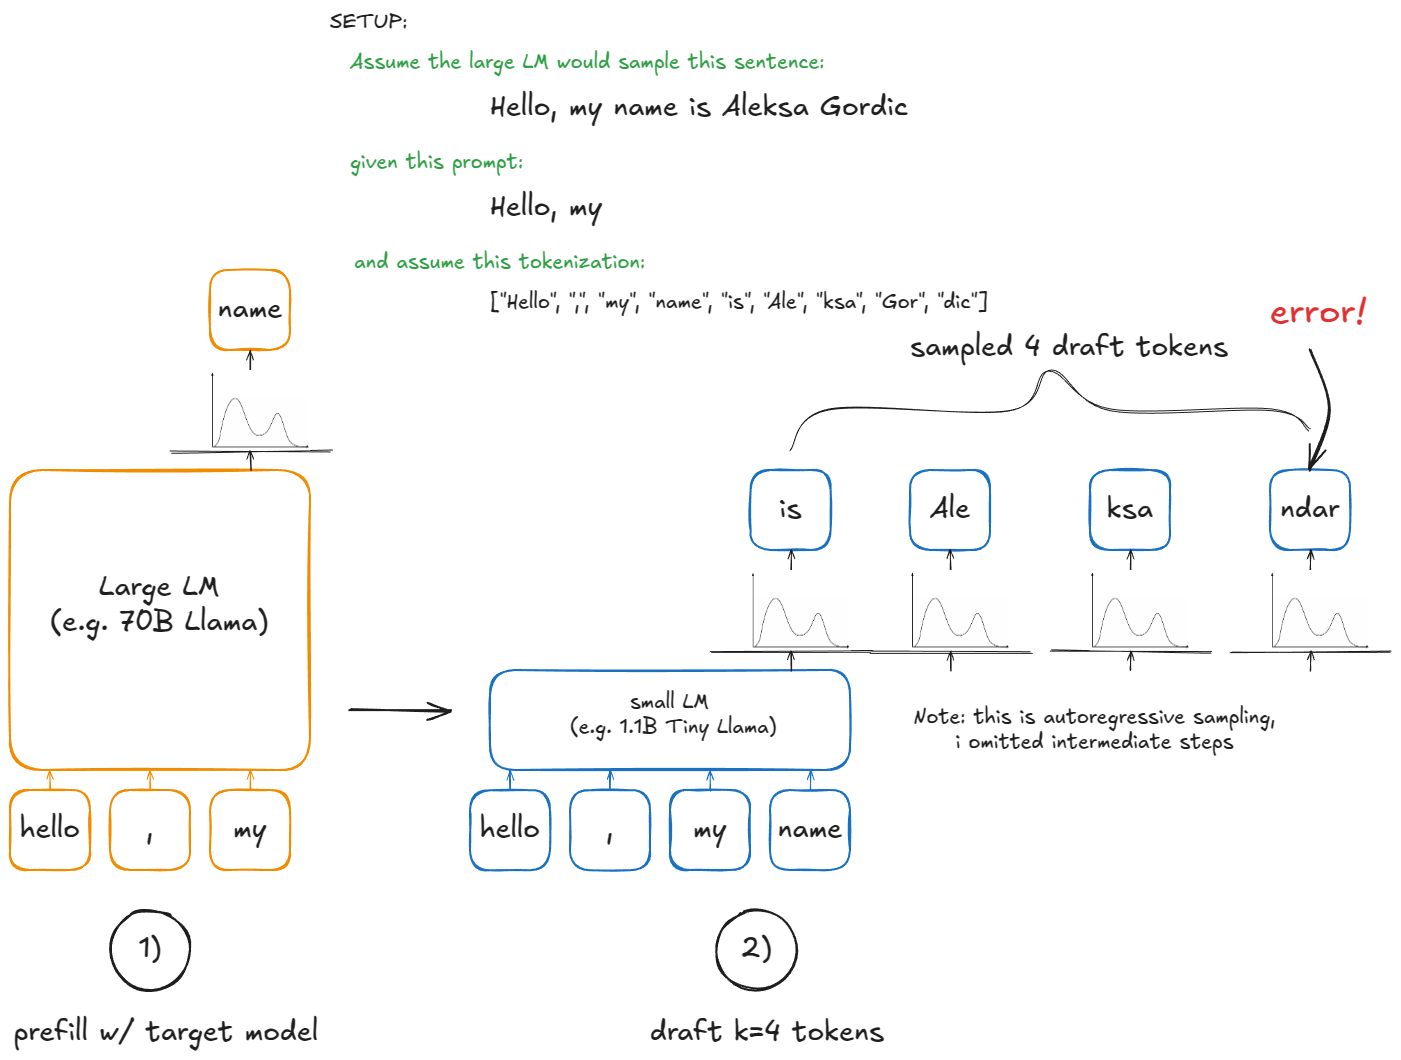
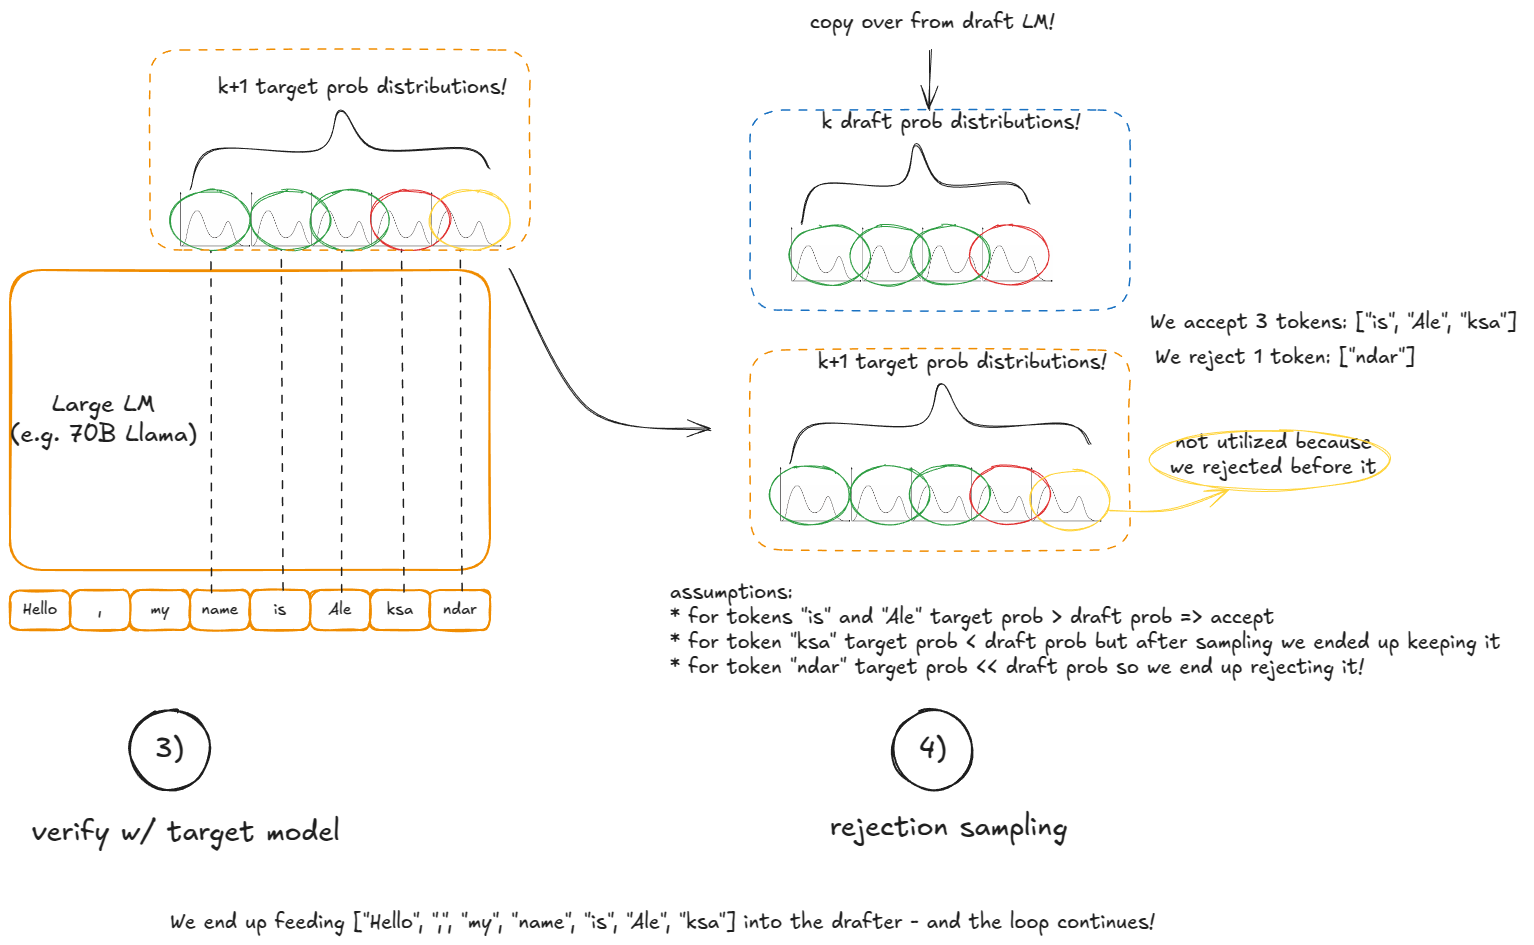
解聚的 P/D
我之前已经暗示了解聚 P/D(预填充/解码)背后的动机。
预填充和解码具有非常不同的性能特征(计算密集 vs. 内存带宽受限),因此将它们的执行分离是一种合理的设计。它能更严格地控制延迟——包括 TTFT(首 token 延迟)和 ITL(token 间延迟)——更多内容见 基准测试 章节。
在实践中,我们运行 N 个 vLLM 预填充实例和 M 个 vLLM 解码实例,并根据实时请求组合自动扩缩容。预填充 worker 将 KV 写入一个专用的 KV 缓存服务;解码 worker 从中读取。这将长且突发的预填充与稳定、对延迟敏感的解码隔离开来。
这在 vLLM 中如何工作?
为了清晰起见,下面的示例依赖于 SharedStorageConnector,这是一个用于说明机制的调试用连接器实现。
连接器(Connector)是 vLLM 用于处理实例间 KV 交换的抽象。连接器接口尚未稳定,有计划中的一些近期改进会涉及变更,部分可能是破坏性变更。
我们启动 2 个 vLLM 实例(GPU 0 用于预填充,GPU 1 用于解码),然后在它们之间传输 KV 缓存:
import os
import time
from multiprocessing import Event, Process
import multiprocessing as mp

from vllm import LLM, SamplingParams
from vllm.config import KVTransferConfig

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

def run_prefill(prefill_done):
    os.environ["CUDA_VISIBLE_DEVICES"] = "0"

    sampling_params = SamplingParams(temperature=0, top_p=0.95, max_tokens=1)

    ktc=KVTransferConfig(
        kv_connector="SharedStorageConnector",
        kv_role="kv_both",
        kv_connector_extra_config={"shared_storage_path": "local_storage"},
    )

    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)
    llm.generate(prompts, sampling_params)

    prefill_done.set()  # 通知解码实例 KV 缓存已就绪

    # 若解码节点尚未完成,保持预填充节点继续运行;
    # 否则脚本可能过早退出,导致解码不完整。
    try:
        while True:
            time.sleep(1)
    except KeyboardInterrupt:
        print("脚本已被用户停止。")

def run_decode(prefill_done):
    os.environ["CUDA_VISIBLE_DEVICES"] = "1"

    sampling_params = SamplingParams(temperature=0, top_p=0.95)

    ktc=KVTransferConfig(
        kv_connector="SharedStorageConnector",
        kv_role="kv_both",
        kv_connector_extra_config={"shared_storage_path": "local_storage"},
    )

    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)

    prefill_done.wait()  # 阻塞等待来自预填充实例的 KV 缓存

    # 内部会在开始解码循环前先获取 KV 缓存
    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    prefill_done = Event()
    prefill_process = Process(target=run_prefill, args=(prefill_done,))
    decode_process = Process(target=run_decode, args=(prefill_done,))

    prefill_process.start()
    decode_process.start()

    decode_process.join()
    prefill_process.terminate()
📝 注意: 我也试用过
LMCache[11]——最快的生产级连接器(以 NVIDIA 的 NIXL 为后端),但它仍处于最前沿,我遇到了一些 bug。由于它的复杂性大多存在于外部仓库中,SharedStorageConnector是更合适的讲解选择。
下面是 vLLM 中的步骤:
- 实例化(Instantiation)——在引擎构建期间,连接器在两处被创建:
- 在 worker 的 init device 过程中(位于 init worker distributed environment 函数下),角色为 "worker"。
- 在调度器构造函数中,角色为 "scheduler"。
- 缓存查找(Cache lookup)——当调度器处理来自
waiting队列的预填充请求时(在本地前缀缓存检查之后),它调用连接器的get_num_new_matched_tokens。这会检查 KV 缓存服务器中外部缓存的 token。预填充在此处总是得到 0;解码可能有缓存命中。该结果在调用allocate_slots之前被加到本地计数中。 - 状态更新(State update)——调度器随后调用
connector.update_state_after_alloc,记录拥有缓存的请求(预填充为空操作)。 - 元信息构建(Meta build)——在调度结束时,调度器调用
meta = connector.build_connector_meta:- 预填充添加所有
is_store=True的请求(用于上传 KV)。 - 解码添加
is_store=False的请求(用于获取 KV)。
- 预填充添加所有
- 上下文管理器(Context manager)——在前向传播之前,引擎进入一个 KV 连接器上下文管理器:
- 进入时:调用
kv_connector.start_load_kv。对于解码,这从外部服务器加载 KV 并注入分页内存。对于预填充,这是空操作。 - 退出时:调用
kv_connector.wait_for_save。对于预填充,这会阻塞直到 KV 上传到外部服务器。对于解码,这是空操作。
- 进入时:调用
下面是一个可视示例:
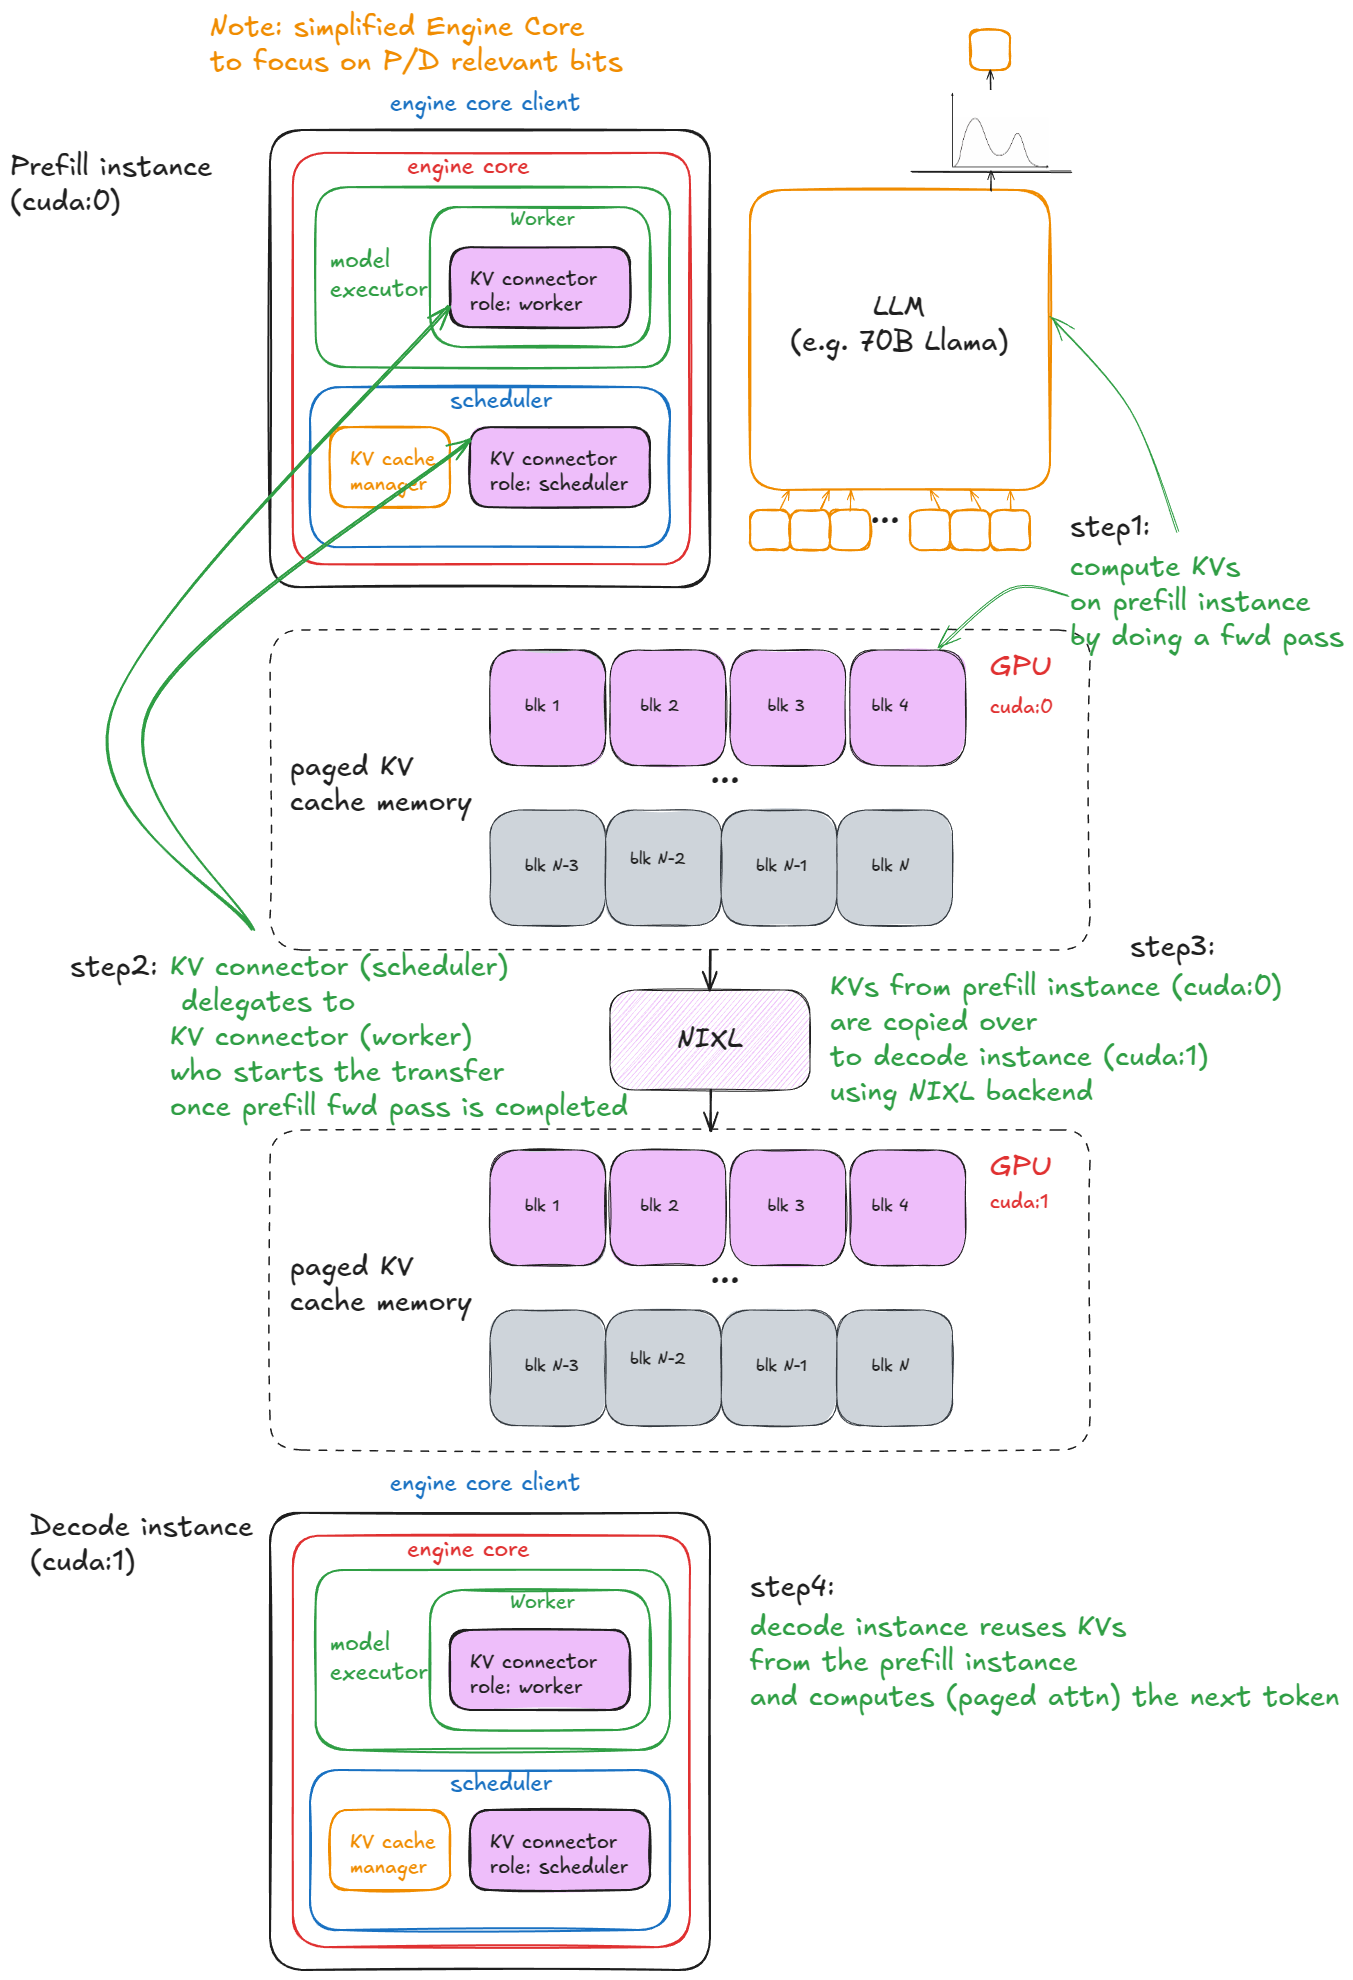
解聚的 P/D
📝 补充说明:
- 对于
SharedStorageConnector,"外部服务器" 只是一个本地文件系统。- 根据配置,KV 传输也可以逐层进行(在每个注意力层之前/之后)。
- 解码仅在请求的第一步加载一次外部 KV;之后在本地计算/存储。
从 UniprocExecutor 到 MultiProcExecutor
核心技巧就位后,我们现在可以讨论扩展规模。
假设你的模型权重无法再装入单个 GPU 的显存。
第一种选择是使用张量并行(例如 TP=8)将模型切分到同一节点的多个 GPU 上。如果模型仍然放不下,下一步就是跨节点的流水线并行。
📝 说明:
- 节点内带宽显著高于节点间,这正是张量并行(TP)通常优于流水线并行(PP)的原因。(同样属实的是,PP 通信的数据量少于 TP。)
- 我不涵盖专家并行(EP),因为我们聚焦的是标准 Transformer 而非 MoE;也不涵盖序列并行,因为 TP 和 PP 是实践中最常用的。
在这个阶段,我们需要多个 GPU 进程(worker)以及一个协调它们的编排层。这正是 MultiProcExecutor 所提供的。
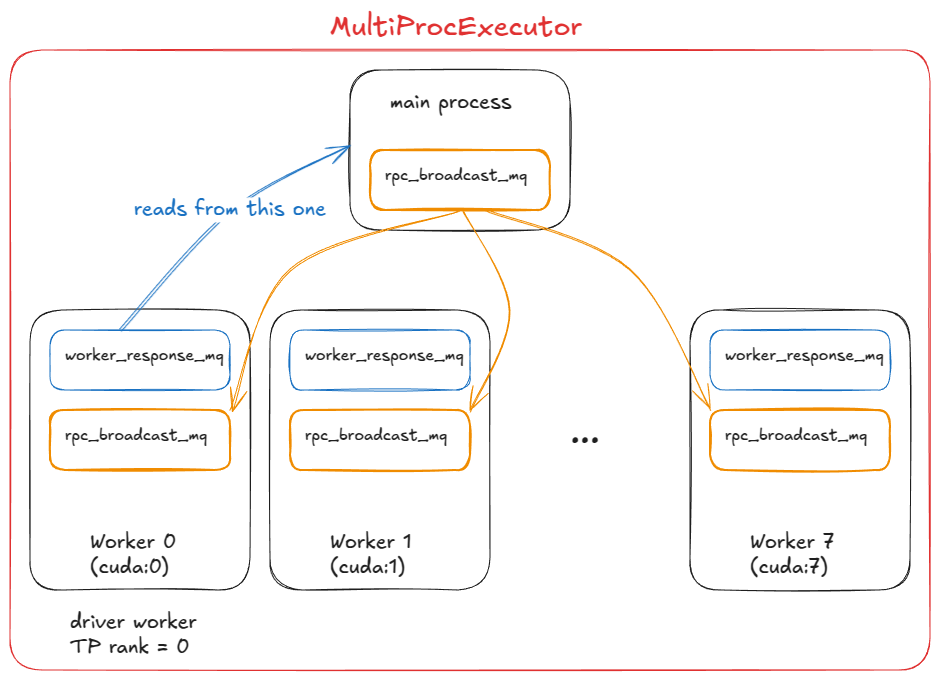
TP=8 设置下的 MultiProcExecutor(驱动 worker 为 rank 0)
这在 vLLM 中如何工作:
MultiProcExecutor初始化一个rpc_broadcast_mq消息队列(底层用共享内存实现)。- 构造函数遍历
world_size(例如TP=8 ⇒ world_size=8),并通过WorkerProc.make_worker_process为每个 rank 生成一个守护进程。 - 对于每个 worker,父进程首先创建一个读管道和写管道。
- 新进程运行
WorkerProc.worker_main,它会实例化一个 worker(经历与UniprocExecutor中相同的 "init device"、"load model" 等步骤)。 - 每个 worker 判断自己是驱动者(TP 组中的 rank 0)还是普通 worker。每个 worker 建立两个队列:
rpc_broadcast_mq(与父进程共享)用于接收工作。worker_response_mq用于回送响应。
- 初始化期间,每个子进程通过管道将其
worker_response_mq句柄发送给父进程。一旦全部收到,父进程解除阻塞——协调完成。 - 随后 worker 进入忙等待循环,阻塞在
rpc_broadcast_mq.dequeue上。当工作项到达时,它们执行它(与UniprocExecutor中类似,但现在带有 TP/PP 特定的切分工作)。结果通过worker_response_mq.enqueue回送。 - 运行时,当请求到达时,
MultiProcExecutor将其(非阻塞地)入队到所有子 worker 的rpc_broadcast_mq。然后它等待指定输出 rank 的worker_response_mq.dequeue来收集最终结果。
从引擎的角度看,一切都没有改变——所有这些多进程复杂性都通过对模型执行器 execute_model 的调用来抽象掉。
- 在
UniProcExecutor情况下:execute_model直接导向在 worker 上调用execute_model - 在
MultiProcExecutor情况下:execute_model通过rpc_broadcast_mq间接导向在每个 worker 上调用execute_model
至此,我们可以使用相同的引擎接口运行资源所允许的任意规模的模型。
下一步是横向扩展:启用数据并行(DP > 1),在节点间复制模型,添加一个轻量 DP 协调层,引入副本间的负载均衡,并在前端放置一个或多个 API 服务器来处理接入流量。
分布式系统服务 vLLM
搭建服务基础设施的方法有很多,但为了具体,这里给出一个示例:假设我们有两个 H100 节点,并希望在其上运行四个 vLLM 引擎。
如果模型需要 TP=4,我们可以这样配置节点。
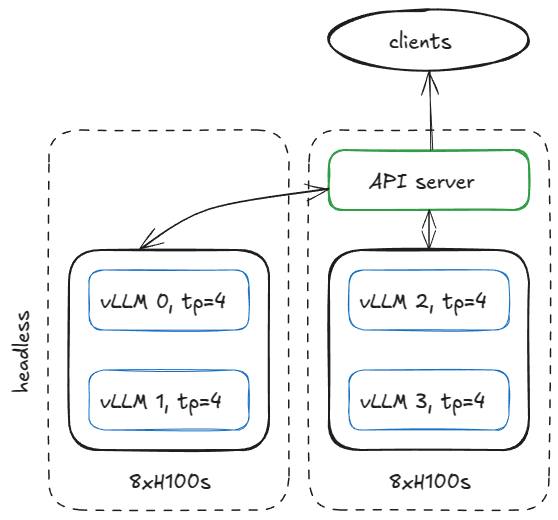
2 个 8×H100 节点的服务器配置(1 个无头节点,1 个 API 服务器)
在第一个节点上,使用以下参数以无头模式(无 API 服务器)运行引擎:
vllm serve <model-name>
  --tensor-parallel-size 4
  --data-parallel-size 4
  --data-parallel-size-local 2
  --data-parallel-start-rank 0
  --data-parallel-address <master-ip>
  --data-parallel-rpc-port 13345
  --headless
并在另一个节点上运行相同的命令,仅做少量修改:
- 不加
--headless - 修改 DP 起始 rank
vllm serve <model-name>
  --tensor-parallel-size 4
  --data-parallel-size 4
  --data-parallel-size-local 2
  --data-parallel-start-rank 2
  --data-parallel-address <master-ip>
  --data-parallel-rpc-port 13345
📝 注意: 这假设网络已配置好,使得所有节点都能访问指定的 IP 和端口。
这在 VLLM 中如何工作?
在无头服务器节点上
在无头节点上,CoreEngineProcManager 启动 2 个进程(按 --data-parallel-size-local),每个运行 EngineCoreProc.run_engine_core。这些函数各自创建一个 DPEngineCoreProc(引擎核心),然后进入忙等待循环。
DPEngineCoreProc 初始化其父类的 EngineCoreProc(EngineCore 的子类),它:
- 创建
input_queue和output_queue(queue.Queue)。 - 使用
DEALER类型的 ZMQ 套接字(异步消息库)与另一节点上的前端进行初始握手,并接收协调地址信息。 - 初始化 DP 组(例如使用 NCCL 后端)。
- 用
MultiProcExecutor初始化EngineCore(如前所述,在 4 个 GPU 上TP=4)。 - 创建一个
ready_event(threading.Event)。 - 启动一个输入守护线程(
threading.Thread)运行process_input_sockets(…, ready_event)。同样启动一个输出线程。 - 仍在主线程中,等待
ready_event,直到横跨 2 个节点的全部 4 个进程中的所有输入线程都完成协调握手,最终执行ready_event.set()。 - 一旦解除阻塞,便向前端发送一条 "ready" 消息,附带元数据(例如分页 KV 缓存内存中可用的
num_gpu_blocks)。 - 随后,主线程、输入线程和输出线程分别进入各自的忙等待循环。
简而言之:我们最终得到 4 个子进程(每个 DP 副本一个),每个运行一个主线程、输入线程和输出线程。它们与 DP 协调器和前端完成协调握手,然后每个进程的这三个线程都进入稳态的忙等待循环。
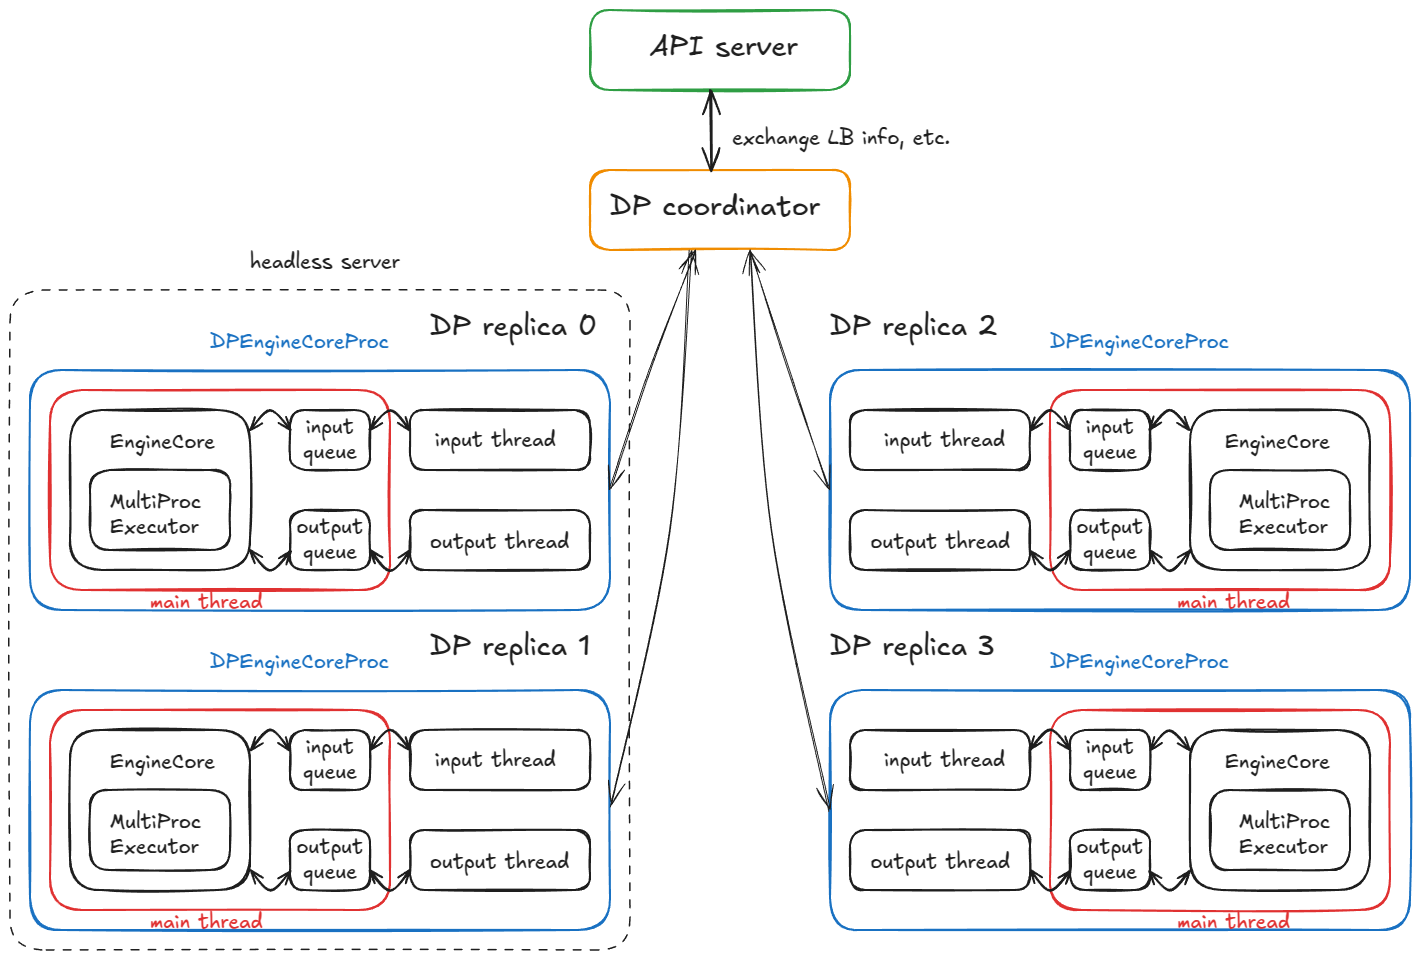
运行 4 个 DPEngineCoreProc 的分布式系统(4 个 DP 副本)
当前稳态:
- 输入线程——阻塞在输入套接字上,直到有请求从 API 服务器路由过来;收到后,它解码负载,通过
input_queue.put_nowait(...)将工作项入队,然后回到对套接字的阻塞。 - 主线程——在
input_queue.get(...)上唤醒,将请求喂入引擎;MultiProcExecutor运行前向传播,并将结果入队到output_queue。 - 输出线程——在
output_queue.get(...)上唤醒,将结果发送回 API 服务器,然后恢复阻塞。
附加机制:
- DP 波次计数器——系统追踪"波次(waves)";当所有引擎都变为空闲时它们静默下来,而当新工作到达时计数器递增(对协调/指标有用)。
- 控制消息——API 服务器可以发送的不只是推理请求(例如中止和工具/控制 RPC)。
- 用于锁步的空步骤——如果任一 DP 副本有工作,所有副本都执行一次前向步骤;没有请求的副本执行一个空步骤,以参与所需的同步点(避免阻塞活跃副本)。
关于锁步的澄清:这实际上只在 MoE 模型中是必需的,其中专家层构成 EP 或 TP 组,而注意力层仍是 DP。目前它总是用 DP 来做——这只是因为"内置"的非 MoE DP 用途有限,因为你完全可以运行多个独立的 vLLM,并以常规方式在它们之间进行负载均衡。
现在看第二部分,在 API 服务器节点上发生了什么?
在 API 服务器节点上
我们实例化一个 AsyncLLM 对象(LLM 引擎的 asyncio 封装)。其内部创建一个 DPLBAsyncMPClient(数据并行、负载均衡、异步、多进程客户端)。
在 MPClient 的父类中,launch_core_engines 函数运行,它:
- 创建用于启动握手的 ZMQ 地址(如无头节点上所见)。
- 生成一个
DPCoordinator进程。 - 创建一个
CoreEngineProcManager(与无头节点上相同)。
在 AsyncMPClient(MPClient 的子类)中,我们:
- 创建一个
outputs_queue(asyncio.Queue)。 - 我们创建一个 asyncio 任务
process_outputs_socket,它通过输出套接字与全部 4 个DPEngineCoreProc的输出线程通信,并写入outputs_queue。 - 随后,
AsyncLLM的另一个 asyncio 任务output_handler从该队列读取,并最终将信息发送给create_completion函数。
在 DPAsyncMPClient 中,我们创建一个 asyncio 任务 run_engine_stats_update_task,用于与 DP 协调器通信。
DP 协调器位于前端(API 服务器)与后端(引擎核心)之间。它:
- 定期向前端的
run_engine_stats_update_task发送负载均衡信息(队列大小、waiting/running 请求数)。 - 处理来自前端的
SCALE_ELASTIC_EP命令,动态改变引擎数量(仅在使用 Ray 后端时有效)。 - 向后端发送
START_DP_WAVE事件(由前端触发时),并回报波次状态更新。
总结一下,前端(AsyncLLM)运行若干个 asyncio 任务(记住:是并发,而非并行):
- 一类任务通过
generate路径处理输入请求(每个新客户端请求生成一个新 asyncio 任务)。 - 两个任务(
process_outputs_socket、output_handler)处理来自底层引擎的输出消息。 - 一个任务(
run_engine_stats_update_task)维护与 DP 协调器的通信:发送波次触发、轮询 LB 状态,并处理动态扩缩容请求。
最后,主服务器进程创建一个 FastAPI 应用,并挂载诸如 OpenAIServingCompletion 和 OpenAIServingChat 之类的端点,它们暴露 /completion、/chat/completion 等。随后该栈通过 Uvicorn 提供服务。
那么,把所有内容整合起来,下面就是完整的请求生命周期!
你从终端发送:
curl -X POST http://localhost:8000/v1/completions -H "Content-Type: application/json" -d '{
  "model": "TinyLlama/TinyLlama-1.1B-Chat-v1.0",
  "prompt": "The capital of France is",
  "max_tokens": 50,
  "temperature": 0.7
}'
接下来发生的事:
- 请求命中 API 服务器上
OpenAIServingCompletion的create_completion路由。 - 该函数异步地对提示进行分词,并准备元数据(请求 ID、采样参数、时间戳等)。
- 然后它调用
AsyncLLM.generate,其流程与同步引擎相同,最终调用DPAsyncMPClient.add_request_async。 - 这进而调用
get_core_engine_for_request,它根据 DP 协调器的状态在引擎间做负载均衡(挑选分数最小/负载最低的引擎:score = len(waiting) * 4 + len(running))。 ADD请求被发送到所选引擎的input_socket。- 在该引擎上:
- 输入线程——解除阻塞,从输入套接字解码数据,并将工作项放到
input_queue供主线程使用。 - 主线程——在
input_queue上解除阻塞,将请求加入引擎,并反复调用engine_core.step(),将中间结果入队到output_queue,直到满足停止条件。提醒:
step()调用调度器、模型执行器(它又可以是MultiProcExecutor!)等。我们已经见过这个了! - 输出线程——在
output_queue上解除阻塞,并通过输出套接字将结果发回。
- 输入线程——解除阻塞,从输入套接字解码数据,并将工作项放到
- 这些结果触发
AsyncLLM的输出 asyncio 任务(process_outputs_socket和output_handler),将 token 回传到 FastAPI 的create_completion路由。 - FastAPI 附上元数据(结束原因、logprobs、使用量信息等),并通过 Uvicorn 向你的终端返回一个
JSONResponse!
就这样,你的补全结果返回了——整套分布式机制都隐藏在一个简单的 curl 命令背后!:) 太有趣了!!!
📝 补充说明:
- 当添加更多 API 服务器时,负载均衡在 OS/套接字层面处理。从应用角度看,没有显著变化——复杂性被隐藏了。
- 以 Ray 作为 DP 后端时,你可以暴露一个 URL 端点(
/scale_elastic_ep),用于自动扩缩引擎副本的数量。
基准测试与自动调优——延迟与吞吐
到目前为止,我们一直在分析"气体分子"——请求如何流经引擎/系统的内部细节。现在是时候放大视野、从整体上审视系统,并问一句:我们如何衡量一个推理系统的性能?
在最高层面上,有两个相互竞争的指标:
- 延迟(Latency)——从请求提交到 token 返回所经历的时间
- 吞吐(Throughput)——系统每秒可生成/处理的 token 或请求数
延迟 对交互式应用最为重要,因为用户正在等待响应。
吞吐 在离线负载中很重要,例如用于训练前/后运行的合成数据生成、数据清洗/处理,以及广义上——任何类型的离线批量推理任务。
在解释为何延迟与吞吐相互竞争之前,先定义几个常见的推理指标:
| 指标 | 定义 |
|---|---|
TTFT(首 token 时间,time to first token) | 从请求提交到收到第一个输出 token 的时间 |
ITL(token 间延迟,inter-token latency) | 两个连续 token 之间的时间(例如从 token i-1 到 token i) |
TPOT(每个输出 token 的时间,time per output token) | 一个请求中所有输出 token 的平均 ITL |
Latency / E2E(端到端延迟,end-to-end latency) | 处理一个请求的总时间,即 TTFT + 所有 ITL 之和,等价于从提交请求到收到最后一个输出 token 的时间 |
Throughput(吞吐) | 每秒处理的总 token 数(输入、输出或两者),或等效地每秒请求数 |
Goodput | 满足服务水平目标(SLO,如最大 TTFT、TPOT 或端到端延迟)的吞吐。例如,只统计满足这些 SLO 的请求所产生的 token |
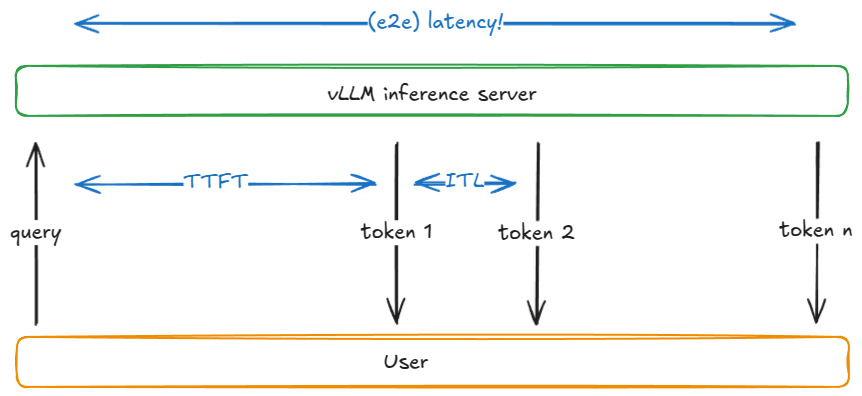
ttft、itl、端到端延迟
下面是一个简化模型,解释这两个指标相互竞争的本质。
假设:权重 I/O(而非 KV 缓存 I/O)占主导;即我们处理的是短序列。
当观察批大小 B 如何影响单个解码步骤时,这种权衡变得清晰。随着 B ↓ 趋向 1,ITL 下降:每步工作量更少,token 不会"与其他 token 竞争"。随着 B ↑ 趋向无穷,ITL 上升,因为每步要做更多 FLOPs——但吞吐改善(直到达到峰值性能),因为权重 I/O 被分摊到更多 token 上。
屋顶线(roofline)模型有助于理解这一点:在饱和批大小 B_sat 以下,步时间由 HBM 带宽主导(将权重逐层流式送入片上内存),因此步延迟近乎平坦——计算 1 个与 10 个 token 可能耗时相近。超过 B_sat 后,内核变为计算密集,步时间大致随 B 增长;每多一个 token 都会增加 ITL。
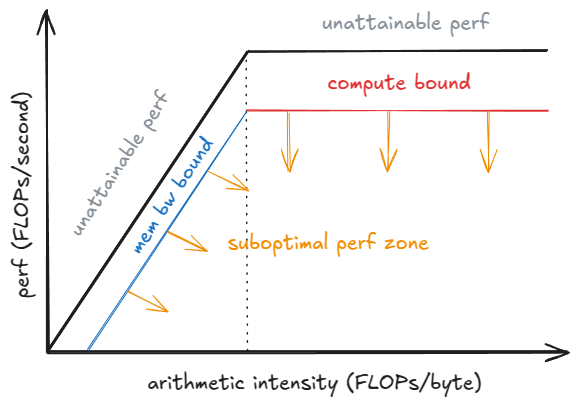
roofline 性能模型
📝 注意: 更严格的处理需要考虑内核自动调优:随着
B增大,运行时可能切换到对该形状更高效的内核,从而改变实际性能P_kernel。步延迟为t = FLOPs_step / P_kernel,其中FLOPs_step是步中的工作量。你可以看到,当P_kernel达到P_peak时,每步更多的计算将直接导致延迟增加。
如何在 vLLM 中做基准测试
vLLM 提供了一个 vllm bench {serve,latency,throughput} CLI,它封装了 vllm / benchmarks / {server,latency,throughput}.py。
下面是这些脚本所做的事情:
- latency——使用短输入(默认 32 个 token),以小批量(默认 8)采样 128 个输出 token。它运行若干次迭代,并报告该批的端到端延迟。
- throughput——一次性提交固定的一组提示(默认:1000 个 ShareGPT 样本)(即
QPS=Inf模式),并报告整个运行过程中的输入/输出/总 token 数以及每秒请求数。 - serve——启动一个 vLLM 服务器,并通过从泊松(或更广义地,伽马)分布中采样请求到达间隔时间来模拟真实世界负载。它在一段时间窗口内发送请求,测量我们讨论过的所有指标,并可选地强制服务器端最大并发数(通过信号量,例如将服务器限制为 64 个并发请求)。
下面是如何运行 latency 脚本的示例:
vllm bench latency
  --model <model-name>
  --input-tokens 32
  --output-tokens 128
  --batch-size 8
CI 中使用的基准测试配置位于 .buildkite/nightly-benchmarks/tests。
还有一个自动调优脚本,它驱动 serve 基准测试,寻找满足目标 SLO 的参数设置(例如"在保持 p99 端到端 < 500 ms 的同时最大化吞吐"),并返回建议的配置。
结语
我们从基本的引擎核心(UniprocExecutor)出发,添加了推测解码和前缀缓存等高级特性,扩展到 MultiProcExecutor(含 TP/PP > 1),最终横向扩展,将一切包裹进异步引擎与分布式服务栈——并以如何衡量系统性能收尾。
vLLM 还包含了我跳过的专门处理。例如:
- 多样化的硬件后端: TPU、AWS Neuron(Trainium/Inferentia)等。
- 架构/技术:
MLA、MoE、编码器-解码器(如 Whisper)、池化/嵌入模型、EPLB、m-RoPE、LoRA、ALiBi、无注意力变体、滑动窗口注意力、多模态 LM,以及状态空间模型(如 Mamba/Mamba-2、Jamba) - TP/PP/SP
- 混合 KV 缓存逻辑(Jenga)、更复杂的采样方法(如束采样)等
- 实验性: 异步调度
好的一面是,这些大多与上述主流程正交——你几乎可以把它们当作"插件"来对待(当然,实践中还是有一些耦合的)。
我热爱理解系统。话虽如此,在这个高度上细节密度必然有所下降。在后续文章中,我会放大到具体子系统,深入那些繁琐的细节。
💡 联系我: 如果你在文章中发现任何错误,请私信我——欢迎通过 X、LinkedIn 或 匿名反馈 给我留言。
致谢
原始作品:https://www.aleksagordic.com/blog/vllm
非常感谢 Hyperstack 在过去一年里为我的实验提供 H100!
感谢 Nick Hill(vLLM 核心贡献者,RedHat)、Mark Saroufim(PyTorch)、Kyle Krannen(NVIDIA,Dynamo)以及 Ashish Vaswani 阅读本文的预发布版本并提供反馈!
参考文献
- vLLM — https://github.com/vllm-project/vllm
- "Attention Is All You Need" — https://arxiv.org/abs/1706.03762
- "Efficient Memory Management for Large Language Model Serving with PagedAttention" — https://arxiv.org/abs/2309.06180
- "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model" — https://arxiv.org/abs/2405.04434
- "Jenga: Effective Memory Management for Serving LLM with Heterogeneity" — https://arxiv.org/abs/2503.18292
- "Orca: A Distributed Serving System for Transformer-Based Generative Models" — https://www.usenix.org/conference/osdi22/presentation/yu
- "XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models" — https://arxiv.org/abs/2411.15100
- "Accelerating Large Language Model Decoding with Speculative Sampling" — https://arxiv.org/abs/2302.01318
- "EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty" — https://arxiv.org/abs/2401.15077
- "Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads" — https://arxiv.org/abs/2401.10774
- LMCache — https://github.com/LMCache/LMCache